


累计融资超10亿美元,为什么NVIDIA、AMD、Intel都下注这家CPO公司?
Ayar Labs是一家专注共封装光学(CPO)技术的初创公司,通过将光引擎芯粒(TeraPHY)直接集成到GPU/AI芯片封装内,突破电互连带宽与功耗瓶颈,显著提升AI集群Scale-Up互连能力。其技术获NVIDIA、AMD、Intel等全产业链巨头战略投资,累计融资超10亿美元,估值超50亿美元,正推动光互连从交换机向算力芯片和内存扩展。
 摘要由 Mars AI 生成
文 | 阿尔法公社
随着芯片算力高速迭代,内存与网络带宽的提升却明显滞后。导致这一瓶颈的核心,正是电互连的底层物理极限。
在这一认知前提下,MIT、加州大学伯克利分校及科罗拉多大学博尔德分校的研究人员历时10年联合科研攻关,成功研发出首款通过光信号与内存通信的微处理器芯片。
2015年,这批核心研究人员创立了Ayar Labs,从早期切入高性能计算(HPC)的封装内光学起步,并于2018年A轮融资时果断押注大规模AI基础设施,将商业化重心聚焦于共封装光学(Co-Packaged Optics,CPO)。
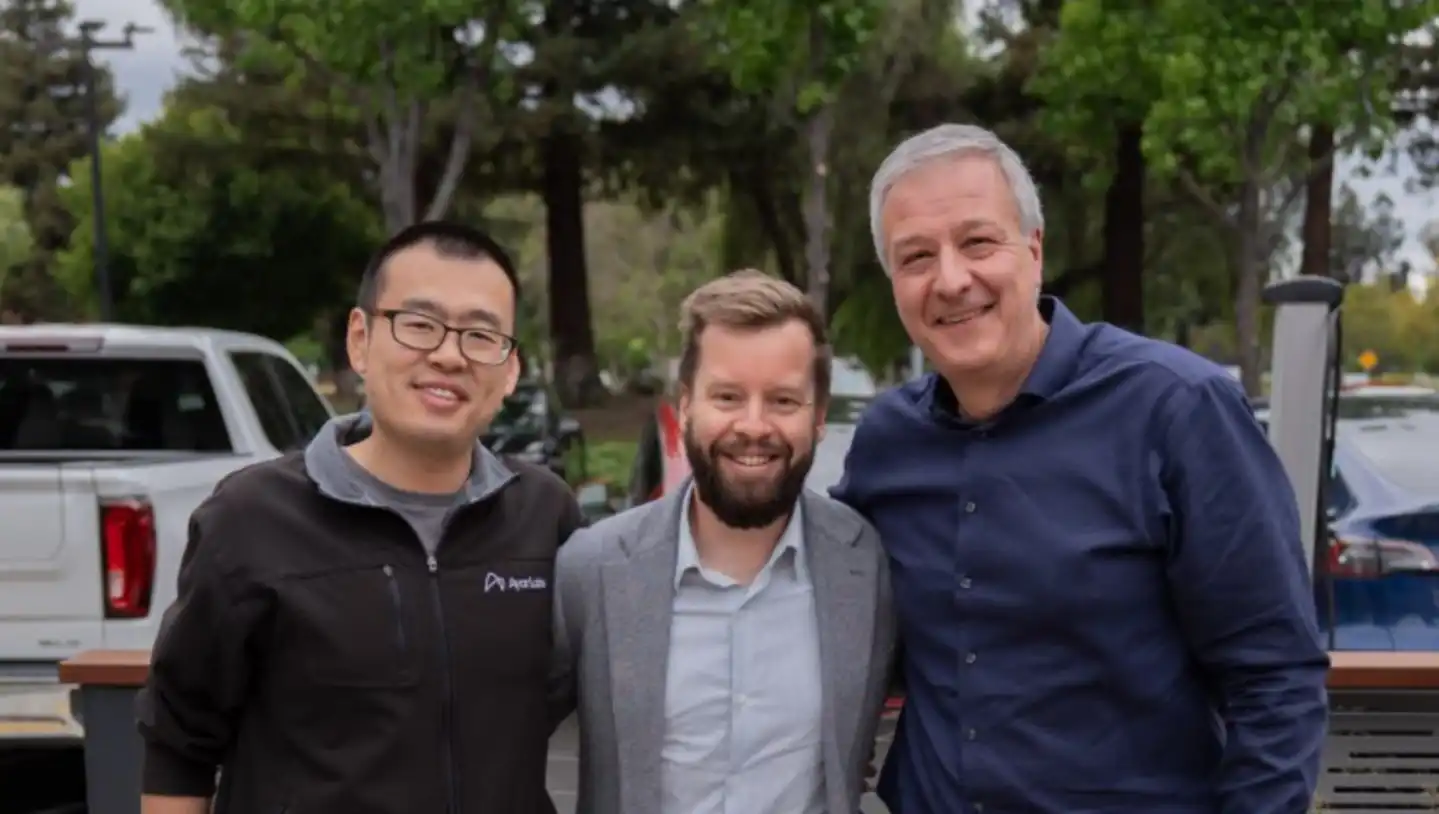 Ayar Labs创始团队:Chen Sun,Mark Wade(CEO),Vladimir Stojanovic。图片来源:Ayar Labs
不同于博通等厂商早期将独立CPO模块与交换芯片组装在同一电路板上的过渡方案,Ayar Labs从一开始就将光引擎芯粒直接封入SoC内部。相比传统的“可插拔光模块+电SerDes”,该方案可将带宽提升至5至10倍、延迟降至十分之一、能效提升4至8倍。
在融资方面,Ayar Labs获得了“战略投资大满贯”,不但有NVIDIA、AMD、Intel、GlobalFoundries、MediaTek、Alchip(世芯电子)等半导体巨头参投,还有电信巨头旗下的NTT DOCOMO Ventures和云基础设施服务器大厂 Wiwynn(纬颖科技)入局。相当于,整个产业链的上下游,都在 Ayar Labs 身上“下注”。
2026年,Ayar Labs获得5亿美元E轮融资和1.5亿美元追加融资。其中,E轮融资由Neuberger Berman领投,参投方包括Alchip、ARK Invest、Insight Partners、MediaTek、Qatar Investment Authority(QIA)、Sequoia Global Equities以及1789 Capital;IAG Capital Partners、Light Street Capital、Playground Global、Founders Fund与GlobalFoundries则在更早期参投。目前它累计融资超10亿美元,据路透社报道,其最新估值已超50亿美元。
为什么是 CPO?Ayar Labs用光打通跨机柜Scale-Up
所谓共封装光学(CPO),指的是将原本位于机箱面板光模块中的“电转光”步骤,直接搬进GPU、ASIC 或交换芯片的同一封装内:
传统的可插拔方案是:GPU/ASIC ➔ 15–30厘米PCB铜走线 ➔ 前面板光模块(内置 DSP 芯片 + 光引擎) ➔ 光纤
CPO共封装方案是:GPU/ASIC ➔ 数毫米封装内电连接 ➔ 共封装光引擎 ➔ 光纤
黄仁勋在2025年GTC大会推出两款集成CPO技术的网络交换机:Quantum-X和 Spectrum-X,分别搭载了1.6T与3.2T的硅光子CPO芯片,目前这两款产品已陆续进入量产交付阶段。
CPO解决的主要是什么问题?是功耗和可扩展问题。
黄仁勋在同一场大会上算过一笔账:在传统方案下,每颗GPU需要配备6个可插拔电光收发器,单个模块功耗达30瓦;若系统扩展至100万颗GPU,仅这一环节的功耗就会高达约180MW(兆瓦),对大规模集群而言显然不可持续。
CPO之所以能大幅降耗,正是因为它将电信号走线从几十厘米缩至数毫米,省去了用于补偿信号衰减的高功耗DSP芯片,使互连能耗降低50%以上。
另一方面,AI基础设施的互连主要分为两个层级:跨节点的横向扩展(Scale-Out)和算力域内部的纵向扩展(Scale-Up)。
横向扩展(Scale-Out):通常利用以太网或InfiniBand等标准网络技术(已广泛采用光互连),将多个独立的计算节点或机柜互连起来,组成超大规模AI计算集群,专为处理数据中心内部较长距离的通信而设计。
纵向扩展(Scale-Up):运行于单个计算节点或超节点(如单机柜72颗GPU)内部,旨在将密集算力芯片之间的通信带宽最大化、延迟降至最低,使多颗芯片能够共享内存、高速协同运算。但在单通道200G速率下,无源高速铜缆的传输极限仅约2米,受此物理限制,当前基于铜互连的纵向扩展网络通常被局限在一到两个机柜之内。
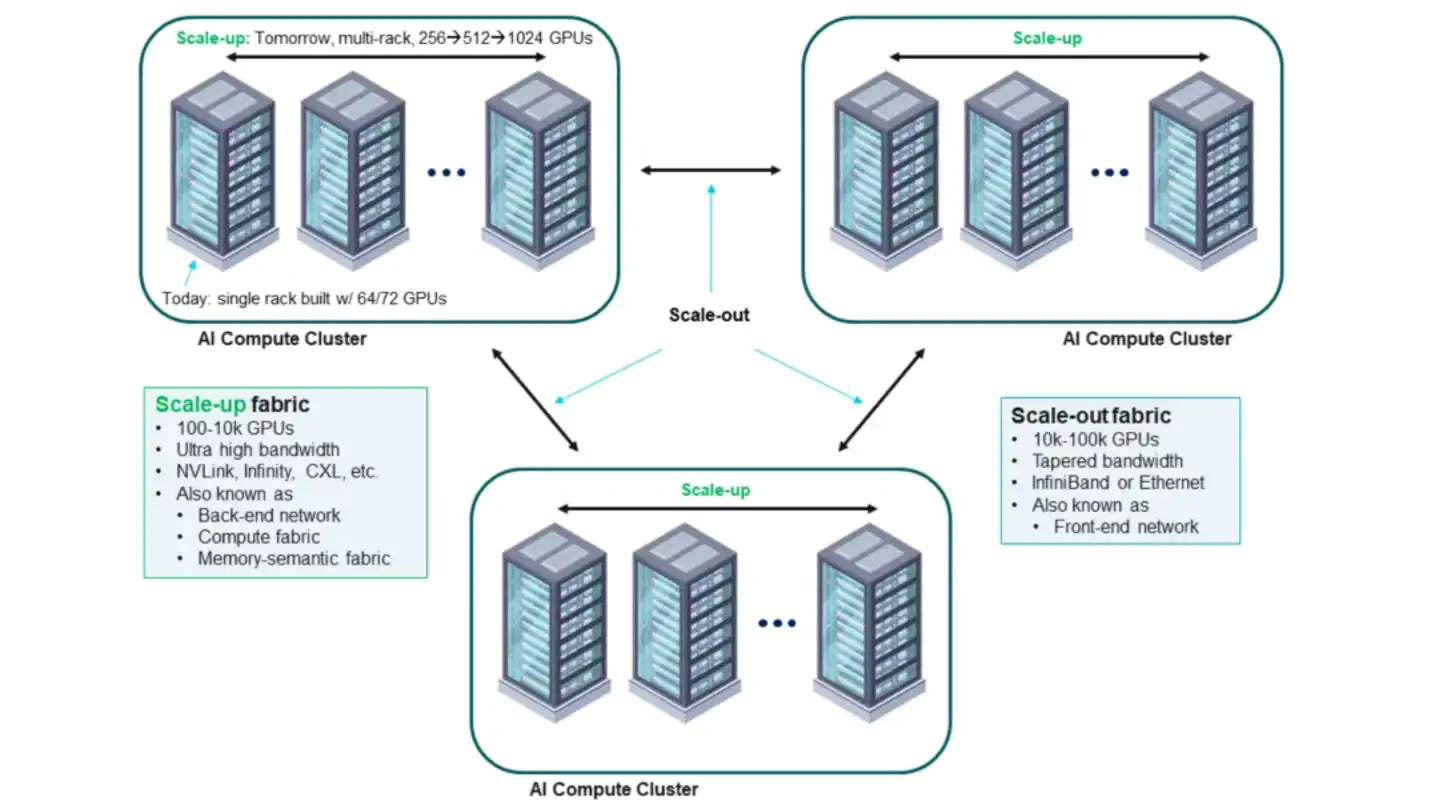 AI计算集群中的Scale-Out与Scale-Up网络,图片来源:Ayar Labs
而CPO能同时突破带宽与距离瓶颈,将跨越多机柜的成百上千颗GPU连成一台统一的“超级计算机”。
这也正是Ayar Labs要发力的方向:他们认为相比于Scale-Out,Scale-Up对单卡带宽的要求至少高出10倍、对延迟的要求则严苛至十分之一,这就必须将光学芯粒直接集成到GPU的封装内部。
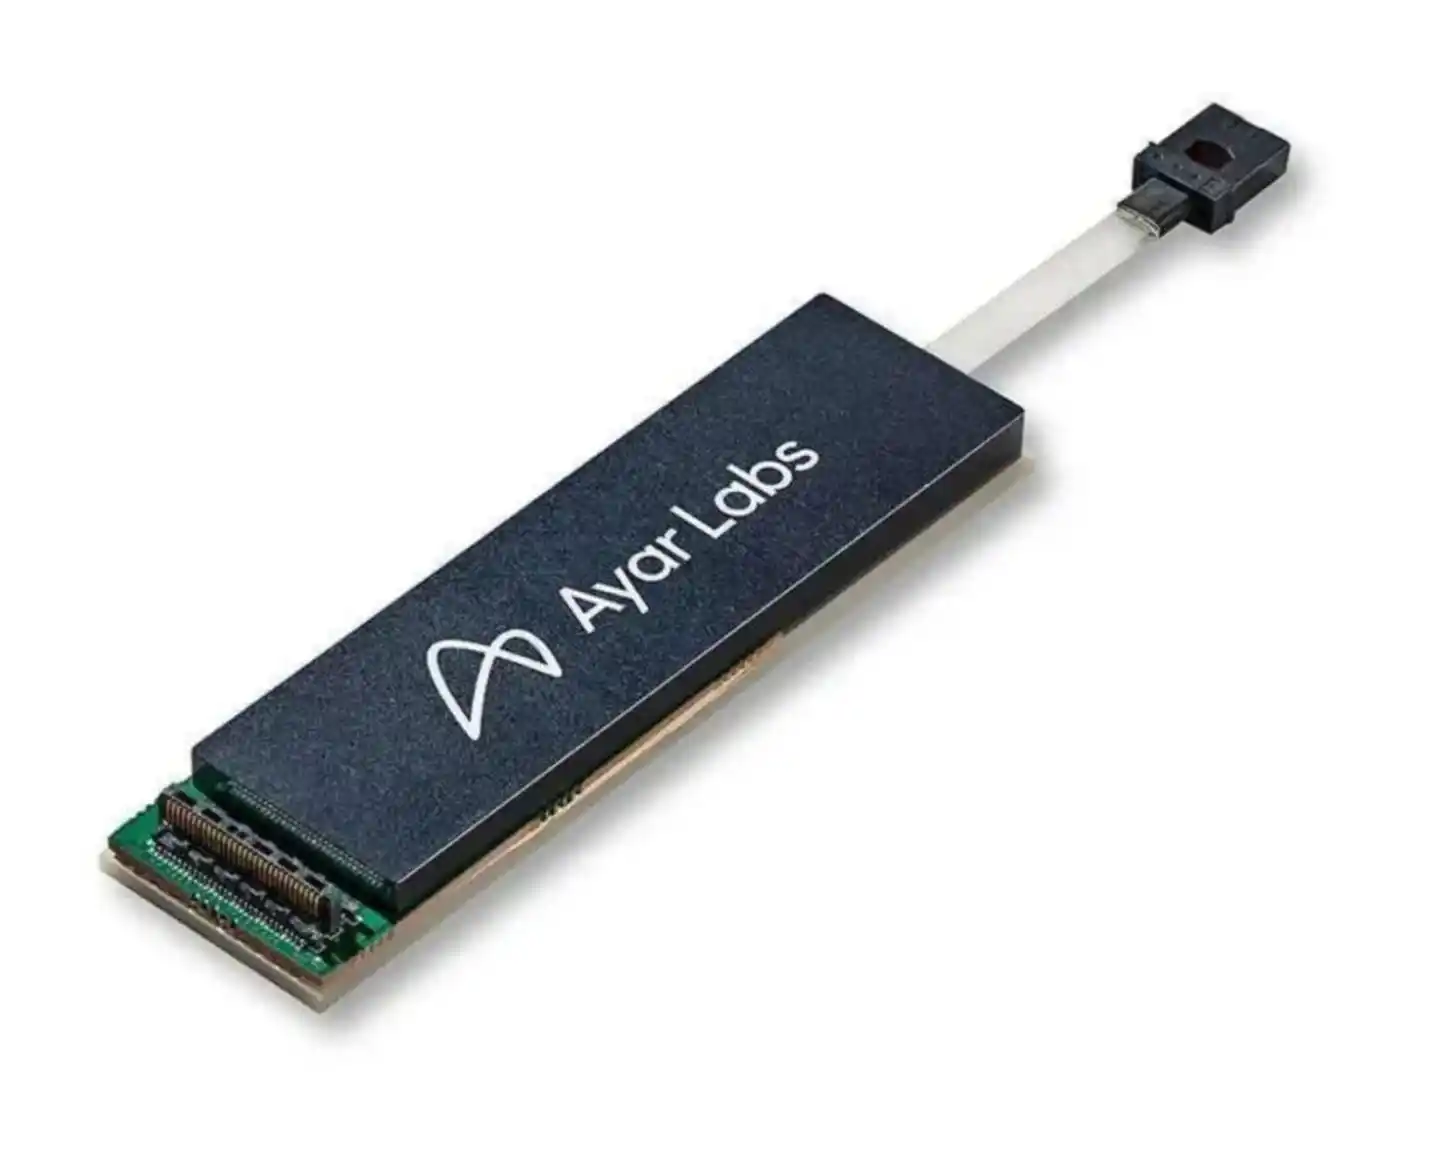
Ayar Labs的光学I/O解决方案具体由两部分组成:共封装在算力芯片内部的TeraPHY光学I/O芯粒,以及独立外置的SuperNova多波长光源。
两者配合,可直接从GPU、CPU或AI加速器封装中引出覆盖毫米至公里级的太比特级(Terabit)光互连。
其中,TeraPHY是一颗将硅光子与标准CMOS工艺结合的光电芯粒,直接与算力主芯片封装在同一基板上,负责就近完成电光转换与信号收发。它采用行业通用的UCIe封装接口,能够方便地对接不同厂商的计算芯片。
在性能指标上,基于45nm工艺的这一代TeraPHY配备了8个光端口,单端口带宽达512Gbps(相当于一条x8 PCIe Gen6链路),单颗芯粒可提供4Tbps单向带宽(8Tbps双向带宽)。由于信号传输质量高、省去了复杂的纠错处理,单颗芯粒的内部延迟仅10纳秒(不含光在光纤中的飞行时间)。
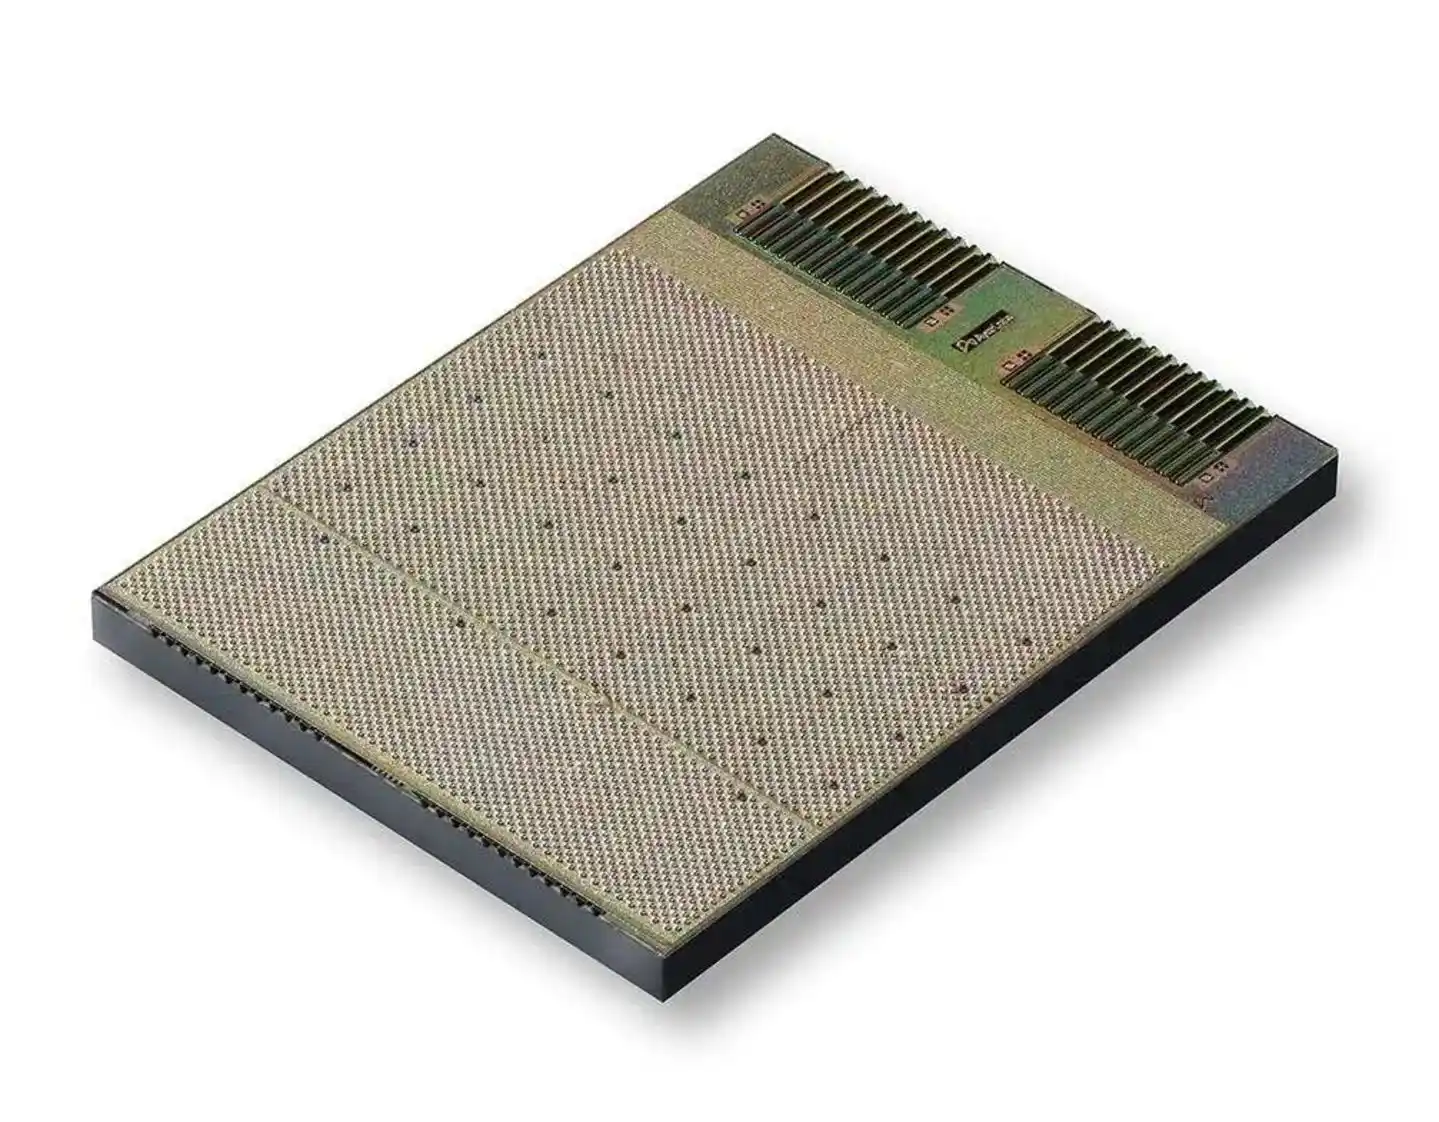 TeraPHY光学I/O芯粒,图片来源:Ayar Labs
另一核心组件SuperNova则是符合行业标准的独立外置光源,负责从芯片封装外部通过光纤为TeraPHY提供稳定的连续激光。这种外置设计让怕热、易老化的激光器远离滚烫的算力芯片,一旦故障可直接拔插替换。
在核心能力上,单台SuperNova可将16种不同波长的激光同时注入16根光纤,为多达256个数据通道提供光载波,最高支撑16Tbps的双向带宽——也就是说,一台SuperNova恰好可以同时驱动两颗8Tbps的TeraPHY芯粒。
 SuperNova 多波长光源,图片来源:Ayar Labs
在最新一代演进中,随着工艺转向台积电COUPE平台,单颗TeraPHY光引擎的单向带宽已跃升至13.5Tbps以上。
针对AI Scale-Up网络从72卡迈向576卡以上时的铜互连极限,Ayar Labs联合定制芯片服务商Alchip与服务器大厂Wiwynn,推出了一套从芯片封装到整机柜的光互连 AI 系统。
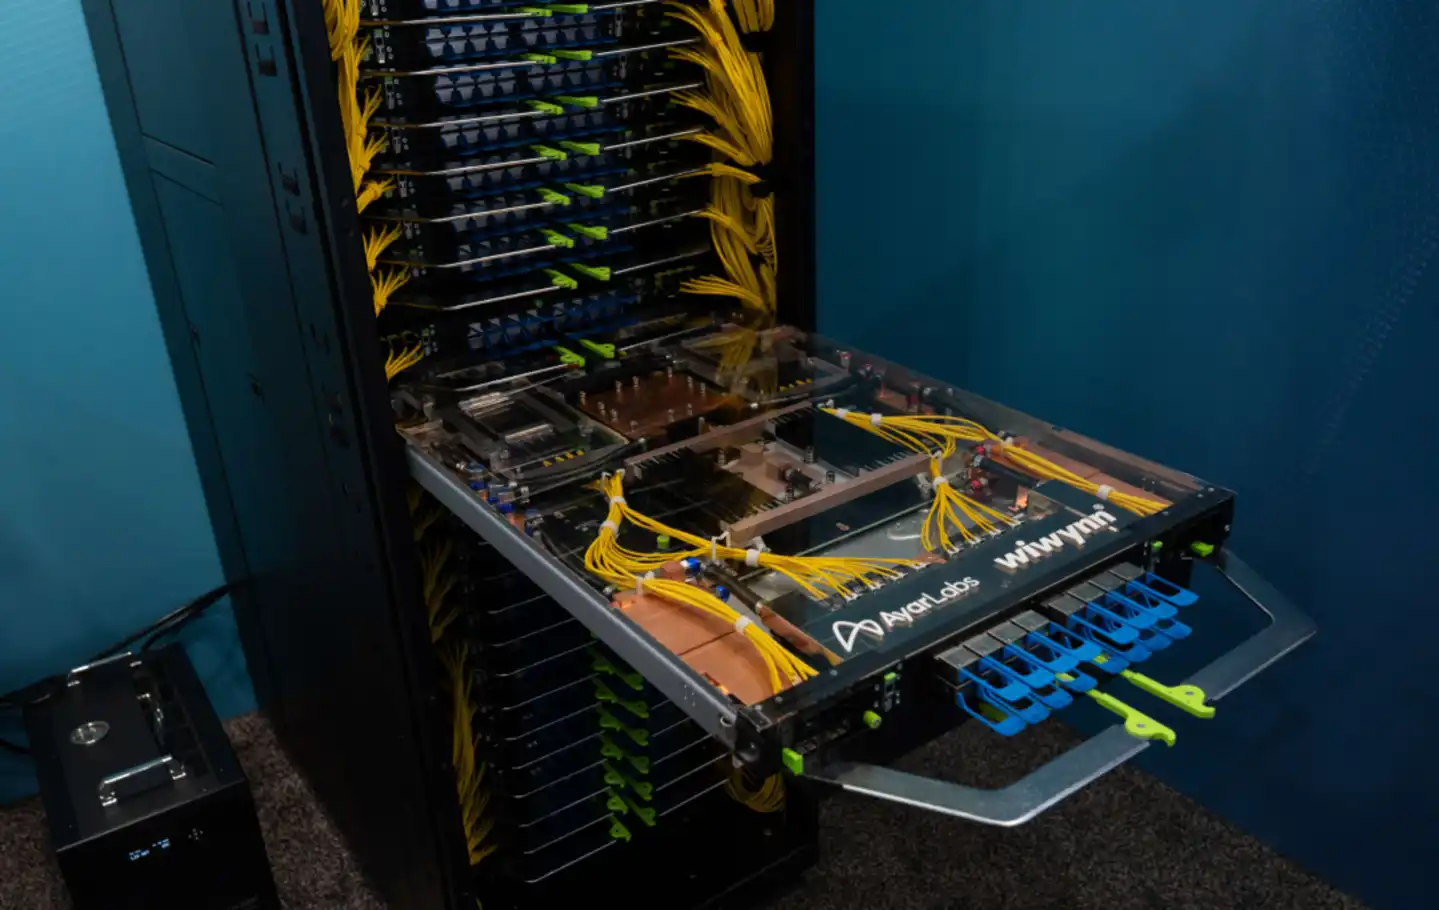 由Wiwynn设计制造的机箱(集成 Ayar Labs的CPO器件与外部光源),图片来源:Ayar Labs
在该系统内部,每个计算托盘搭载1颗CPU与2颗AI ASIC;每颗ASIC四周环绕集成8颗新一代TeraPHY光引擎,配合面板可热插拔的SuperNova外部光源,使单颗加速器即可输出超100Tbps的光带宽。
面对单柜超100kW的高功耗,整机采用100%冷板液冷架构(含外部光源液冷),并支持光纤与光源的无停机维护。
实际效果上,单台机柜可容纳32个计算托盘、将64颗ASIC光互连;将16台机柜相连,即可组成支持1024颗以上加速器的Scale-Up集群,让跨机柜的上千颗芯片在实际运行中像“单颗超大型GPU”一样低延迟协同工作。
算力之外,光互连正推高AI基础设施的上限
CPO的商业化沿着“Scale-Out交换机 ➔ Scale-Up算力芯片 ➔ 光连接扩展内存”三步推进。
2025至2026年,CPO率先在NVIDIA、博通的Scale-Out交换机落地;但据 SemiAnalysis测算,Scale-Out网络仅占集群总功耗的9%,换用CPO对整体成本和功耗的节省只有2%到7%,现阶段主要是产业链跑通制造与验证可靠性的过渡期。
更核心的场景是单卡带宽需求达到Scale-Out网络9倍的Scale-Up网络。2027至2028年预计将迎来量产拐点,CPO将批量进入GPU与AI ASIC封装内部;底层工艺也正从45nm单片集成转向台积电COUPE等3D异构集成。
顺着光信号在集群中的传输路径,光互连链条可分为外部光源、封装侧光电转换和网络层光交换三个环节。
最前端是外置可插拔激光光源,这一环节的初创公司主攻多波长光源,如晶圆级集成16波长的Scintil、已推出8波长模块并规划16至128波长光频梳的Xscape Photonics,以及自研光源的Lightmatter。
中间一环是封装侧光电转换,创业公司分为三条路线:一是置于芯片四周的光学芯粒,代表有采用UCIe标准的Ayar Labs、主打以太网互通的Ranovus,及使用二维光纤阵列的Nubis(已被Ciena收购);
二是铺在芯片正下方、绕开边缘限制的光中介层与光桥,代表有Celestial AI(已被Marvell收购)和Lightmatter;
三是基板级微光波导,如前Ayar Labs一号员工联合创立的Volantis,用基板上2微米宽的光波导替代铜线,低功耗直连算力与内存池。
到了网络交换层,传统做法是在电交换芯片旁封装CPO,仍需经过“光-电-光”转换;光路交换机(OCS)则省去光电转换,直接在光域内给光信号“改道”。
例如Salience Labs将OCS集成至硅光芯片并配自研光放大芯片,重配置时间低于300微秒,单跳延迟低于10纳秒,仅为传统高性能电交换机的几十分之一。
据Creative Strategies估算,2030年这一光互连赛道的市场规模有望达到300亿至500亿美元。面对芯片巨头的垂直整合,创业公司仍有两类较清晰的机会。
一是以光互连实现“算力与内存解耦”。
现有架构多将GPU与HBM绑定封装,受芯片边缘周长限制,单卡通常只能排布8至12颗HBM,容易造成资源错配(类似的问题在传统云服务器上同样突出,微软Azure曾披露高达25%的服务器内存因算存绑定而闲置)。
随着Agent推理需求增长,用低延迟光互连挂载数十至上百TB共享内存池(如 Celestial AI、Volantis),可缓解内存瓶颈并降低推理成本。
二是成为自研芯片阵营的中立光学供应商。
巨头自研CPO主要服务于封闭生态,而自研AI ASIC的云厂商不愿在底层互连上受制于单一供应商。围绕UCIe等开放标准,联合台积电COUPE及 Alchip、GUC(创意电子)等设计服务商,将光引擎做成接近HBM使用体验的标准化芯粒,有机会在定制芯片市场占据重要位置。
为你推荐
商务合作:TG:@Lottie96
Copyright 火星财经 All Rights Reserved.