


刚刚,DeepSeek张博创业曝光:开源个人Agent
DeepSeek前V1作者及VL项目负责人张博(Tony Zhang)创业推出开源个人Agent系统Linger,专注本地化、隐私优先的办公智能助理,支持在消费级硬件(如12GB显存RTX 3060)上高效运行125B参数大模型,具备主动提醒、本地记忆、隐式学习、桌面操作与多Agent协同等能力。
 摘要由 Mars AI 生成
聚是一团火,散是满天星。
刚刚,前
方向,正是当下最火的个人Personal Agent。
路线也是比较有意思,当同行都在做APP,他们优先选择了电脑。
这意味着,Linger能操纵你电脑已有的网页、邮件箱、日历,无需折腾一大堆登录凭据。
遇到卡住的地方,你也可以直接上手接管。
另外一个点,作为中间层的Linger,支持接入各个第三方模型。
并且专门为本地LLM做了优化。
具体来说,一块12GB显存的RTX 3060显卡,就能跑起一个125B参数的Qwen3.8-Flash-Next,并且是45.5 tokens/秒的生成速度。
对了,还有个蛮重要的事情——
这套系统是开源的。。。
至于为什么?
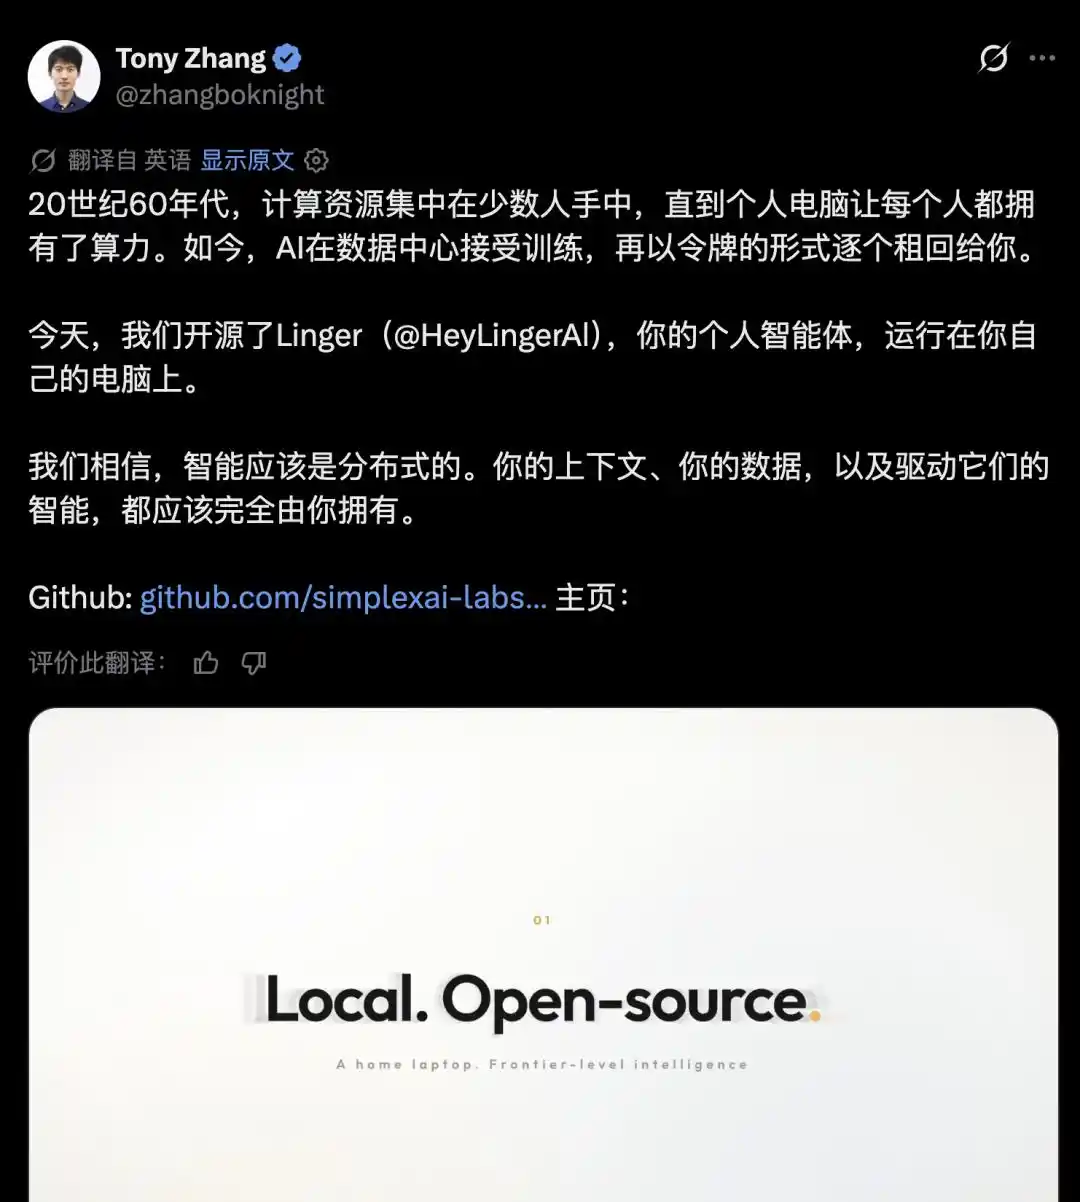
在官宣帖中,Tony Zhang引用了PC崛起的历史:
1960年代,计算是中心化的,直到PC将权力交到每个人手中。如今,AI在数据中心训练,然后以token的形式租给你。
我们相信智能应该是分布式的。你的上下文、你的数据,以及驱动它们的智能,都应该完全由你拥有。
所以今天,他们开源了Linger,一个生活在你个人电脑上的专属Agent。
也是延续大肥鲸优良传统了😭。
一个「会主动,能自学」的AI
Linger的的核心,是名为「Another Me」的Agent系统。
它首先是一个记忆中枢。
Linger会在本地读取你的收件箱、日历、聊天记录和会议,每晚自动将这些信息整理成个人知识库(Wiki),供所有Agent查询。
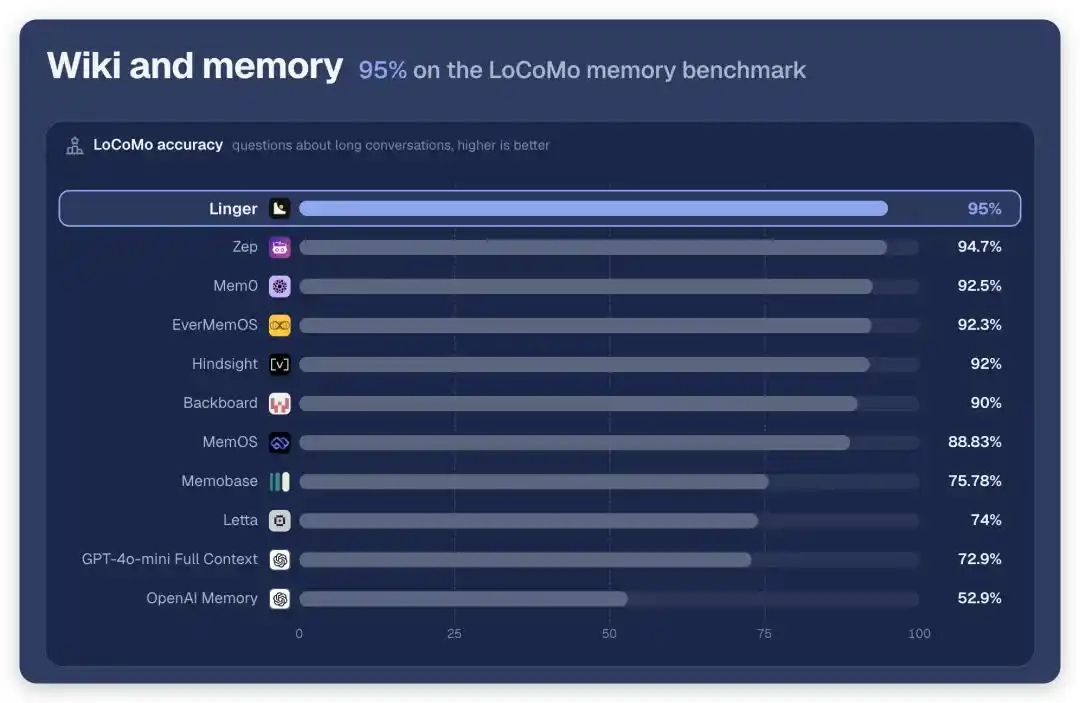
在衡量长期对话记忆能力的LoCoMo基准测试中,Linger的准确率达到了95%,超过了Mem0、MemOS等多个记忆增强型AI系统。
有了这些,Linger便能更好地主动工作。
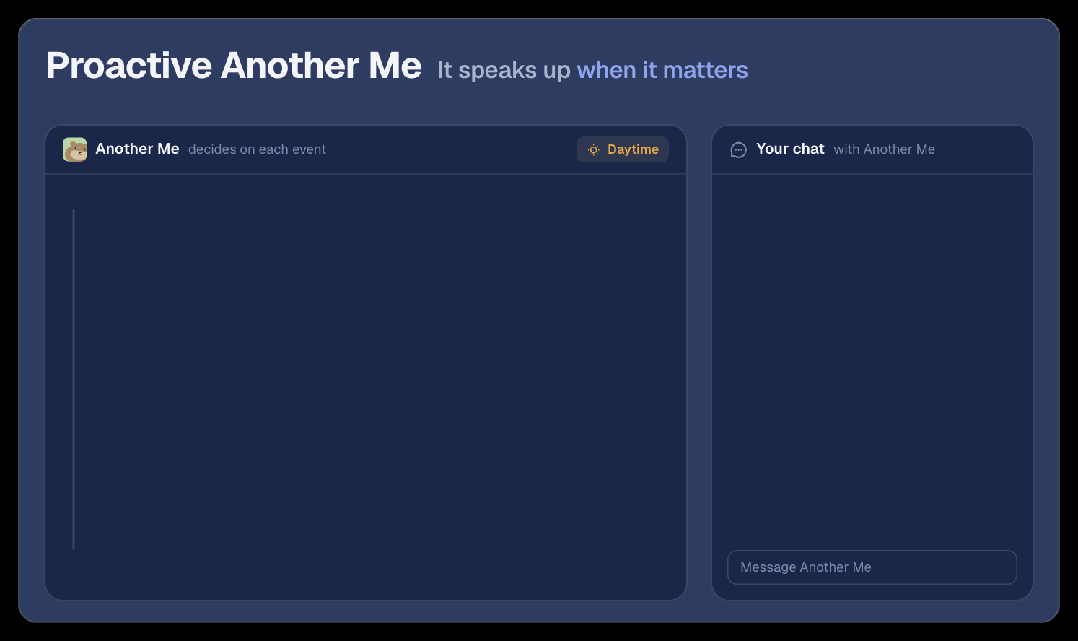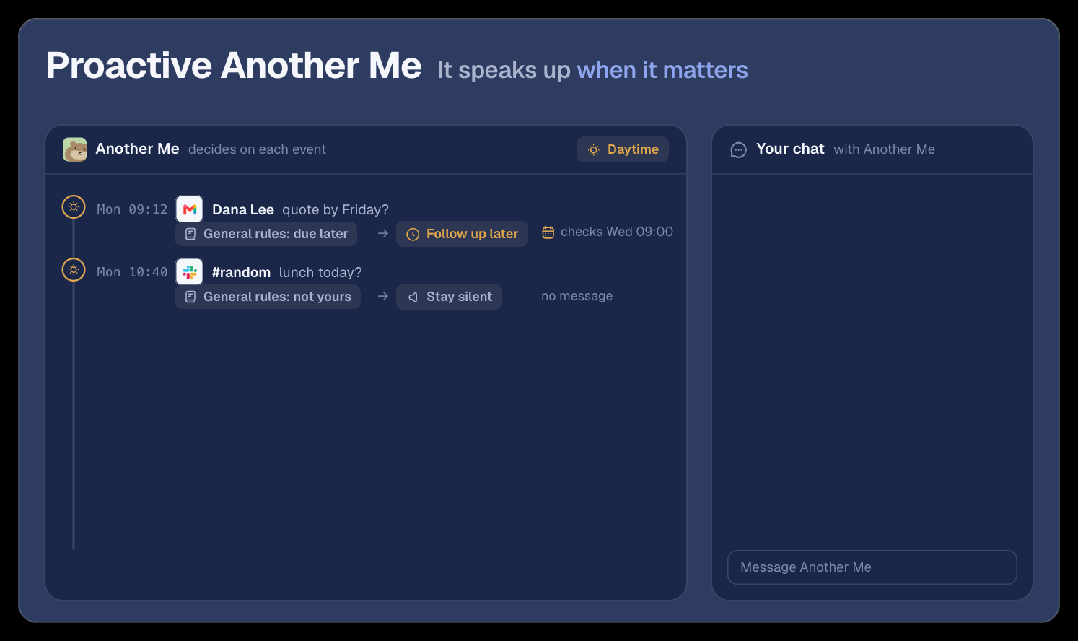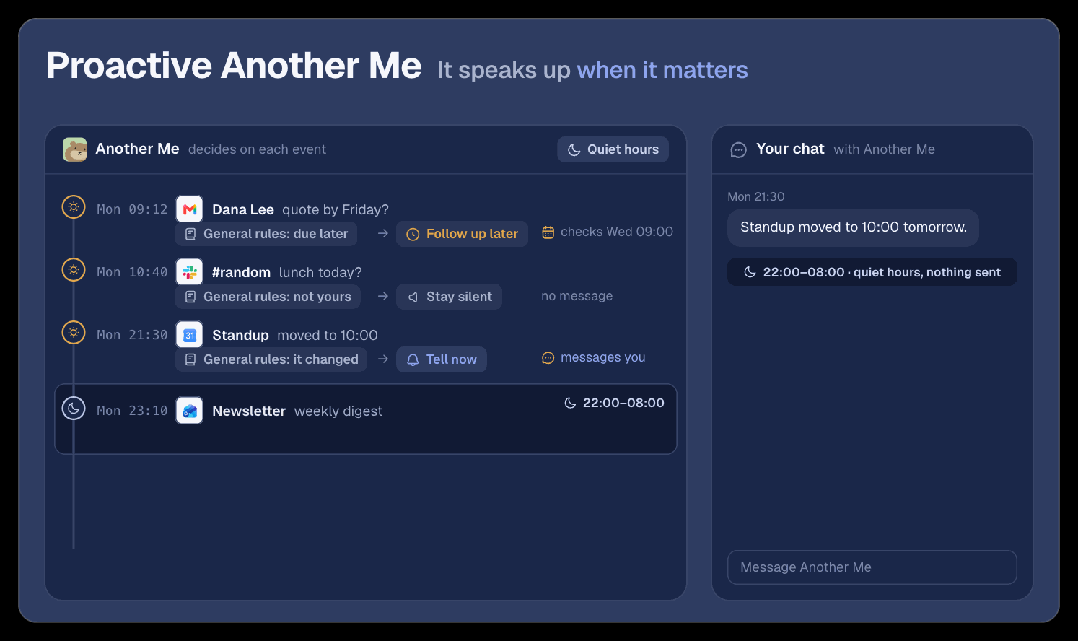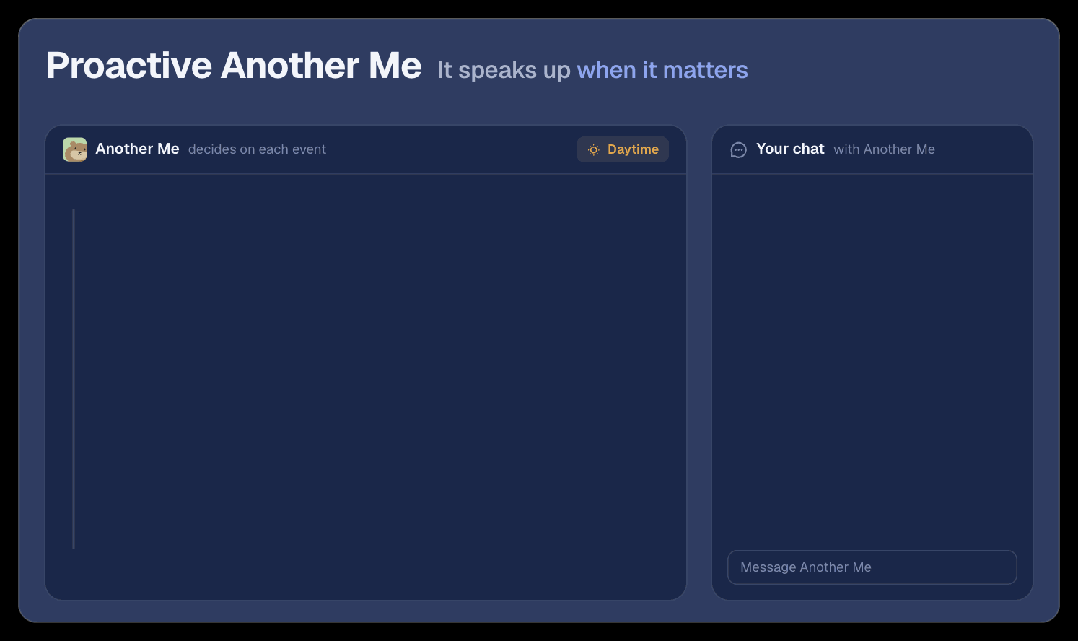
它会默默观察你的信息流,根据事件的重要性和紧急性决定何时提醒你。周一收到客户邮件,要求周五前给报价,它不会立刻打扰,而是等到周三早上再弹出提醒。
但如果是会议时间变更,它会立即通知。
这个Agent还会从你的反馈中自我学习,Linger称之为「隐式强化」。
比如,当它提醒你一张发票快到期了,你回复说「上周就收到了,应该当时就告诉我」。系统会记下一个线索。
如果下一次另一张发票出现类似情况,你再次表达了相同的偏好,系统就会自动生成一条规则:「供应商发票→立即提醒」。
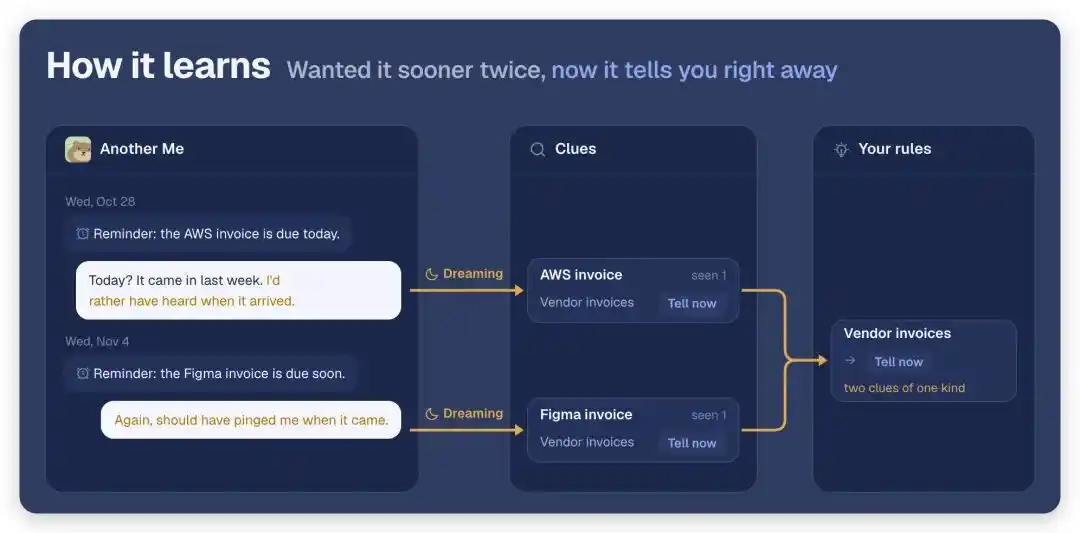
反之,如果你连续两次对「快递提醒」表现出不感兴趣(比如直接忽略或回复「不用告诉我」),它也会学会以后保持沉默。
你也可以直接下指令,一次性教会它。比如告诉它:「客户的回复,要立刻通知我」,或者「晚上9点后,会议变更这种事不用马上说」。
这种持续的交互和学习,让Agent越来越懂你的工作习惯,成为一个真正个性化的助理。
除此之外,Linger还能:
操作桌面和浏览器。
就是开头说的,Linger能直接使用你电脑上已经登录的Chrome、各种App,无需重新配置。
组建Agent团队。
这点就是
你下达一个复杂任务时,Another Me会调用或创建不同职能的Agent,协同完成工作。
而你,只用停留在和Linger的这一个Session。
语音交互。
这点主要就是服务于办公场景了。
Linger能实时转录会议,会后直接向Agent提问会议内容,并让它跟进待办事项。
总而言之呢,就是一个专为办公场景优化的Personal Agent。
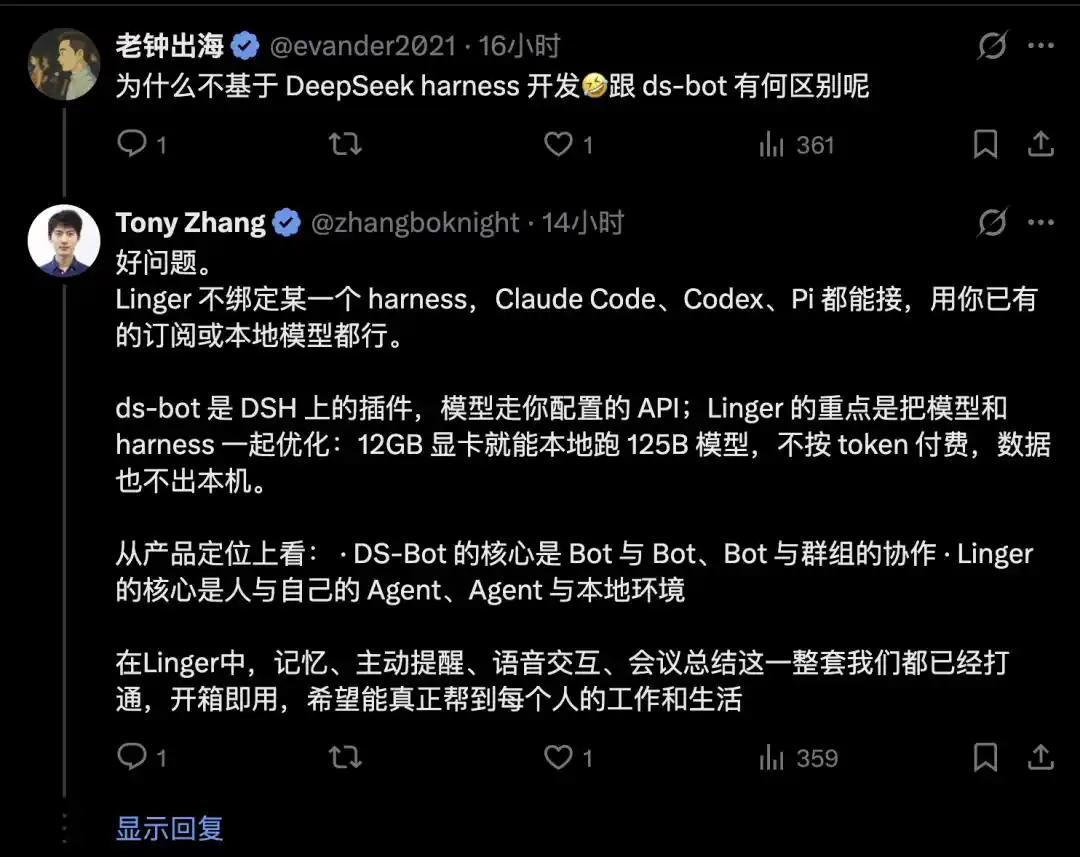
不过,也有网友对这一产品定位不太理解:
为什么不基于DeepSeek harness开发🤣跟ds-bot有何区别呢
对此,Tony Zhang回应道:
Linger的重点是把模型和harness一起优化:12GB显卡就能本地跑125B模型,不按token付费,数据也不出本机。
从产品定位上看:DS-Bot的核心是Bot与Bot、Bot与群组的协作;Linger的核心是人与自己的Agent、Agent与本地环境。
12GB显卡,跑125B模型
让消费级硬件运行千亿大模型,Linger的核心技术是一个名为PolyStrata的MoE推理引擎。
它的原理可以理解为一种智能分层存储机制。
对于一个庞大的MoE(专家混合)模型,PolyStrata会把最常用、最活跃的「专家模块」放在最快的GPU显存里,将不那么常用的放在内存中,而使用频率最低的则放在SSD固态硬盘上。
当模型需要调用某个专家时,系统会动态地在GPU、内存和SSD之间移动数据。这样一来,就不需要把整个几十上百GB的模型全部塞进有限的显存里。
效果立竿见影。
根据官方数据,一个125B参数的Qwen3.8-Flash-Next模型,在一台配备12GB RTX 3060和64GB内存的电脑上,可以实现45.5 tokens/秒的生成速度。
在更强的RTX 5090(32GB)上,速度则飙升至179 tokens/秒。
为了让用户更方便地用上本地大模型,Linger还做了一个「模型自动驾驶(Model Autopilot)」功能。
它会自动检测你的硬件配置(GPU、显存、内存),然后从49个语言模型、两种推理引擎、多种量化方案和不同上下文长度的组合中,为你推荐并安装性能最强的模型。
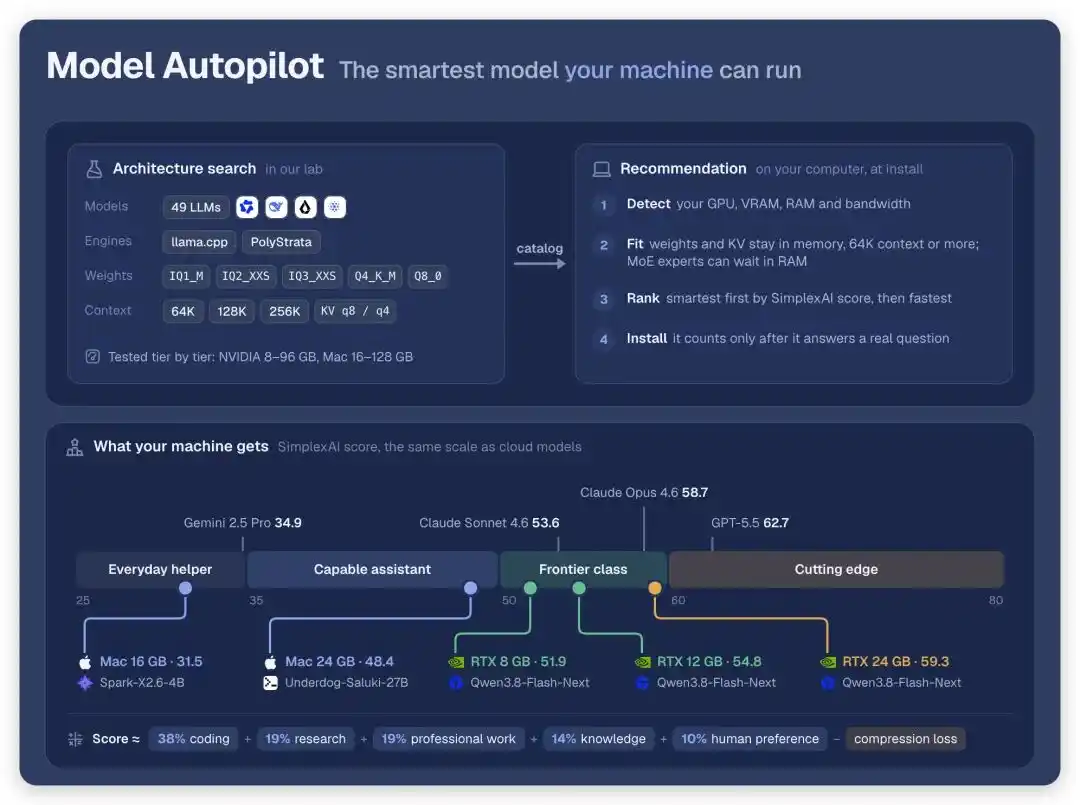
根据SimplexAI的评分体系,不同配置的本地设备可以获得媲美主流云端大模型的能力:
8GB显卡+32GB内存:得分35.4,约等于Gemini 2.5 Pro。
Mac 24GB统一内存:得分51.9,约等于Claude Opus 4.5。
12GB显卡+32GB内存:得分57.3,约等于Claude Opus 4.6。
这意味着,你的游戏本或MacBook,将拥有一个真正强大的、7x24小时待命、没有token费用、并且数据完全不出本地的AI大脑。
DeepSeek-VL负责人再创业
Linger背后,是一支有着深厚技术背景的团队,其创始人Tony Zhang的履历尤为亮眼。
(毕竟是
Tony Zhang本科毕业于浙江大学,2019年在香港科技大学取得博士学位,随后加入微软亚洲研究院(MSRA),长期从事计算机视觉和生成模型研究,是VQ-Diffusion、Rodin 3D数字人等多个知名项目的作者。
2023年,他加入
在这里,他不仅参与了早期语言模型
离开
Linger就是Simplex AI的最新作品。
而作为Linger技术核心,那个专为本地部署而生的推理引擎?
据Tony Zhang透露,由团队里一位18岁的天才少年构建。
18岁?高中刚毕业?
本文来自微信公众号“量子位”,作者:Jay
为你推荐
商务合作:TG:@Lottie96
Copyright 火星财经 All Rights Reserved.