



年内第18次宕机,融资千亿的DeepSeek反而更脆弱了?
DeepSeek年内已宕机18次,近期大规模服务中断暴露其在高速扩张中算力基建与工程团队严重滞后的问题;尽管融资规模达千亿元、估值5000亿元,并加速建设数据中心、招聘数百名工程师,但复杂AI任务激增与系统升级滞后导致稳定性持续承压,凸显大模型公司规模化落地的技术与组织挑战。
 摘要由 Mars AI 生成
没想到AI比打工人们更不想上班。
15日早上8点后,
熟悉的配方,熟悉的味道。网友们纷纷表示:“村里人都等着用呢”“这次宕的你有点久了”“是不是要发布新版本了”。
当然,对AI玩家来说,大模型供应商突发宕机已经屡见不鲜,不过这次宕机范围之大、宕机时间之长,确实还是有点出乎了用户们的预料。
毕竟现在的
走到现在的
为了不宕机,DeepSeek拼了
只看今年,
出现的状况也五花八门,既有网页和API性能下降,也有部分服务中断。
当然,如果是从去年2月就开始关注
最离谱的是去年2月底,由于服务器资源紧张,
用户想“氪金”使用,都没地方充,
当然,当时的
但一年多过去了,
这当然说不过去,所以
今年6月,公司就曾启动大规模招聘。到了9月,Harness团队又开放了约150个招聘名额,重点补充服务端开发、Agent弹性计算等工程岗位,工作涉及API、线上服务和计算平台的开发维护。
除了找人,
从官方招聘网站看,
这些投入,自然少不了钱。
据《财经》报道,
此前关于首轮融资的报道也提到,超过六成资金将用于算力基础设施建设。用户期待融资能改善“服务器繁忙”,也合情合理。
只是问题可能在于,有钱、有人了,可能还是没法彻底解决宕机问题。
OpenAI也干了
或许AI公司之间也有“心有灵犀”,就在
10月15日,部分ChatGPT用户在新建对话时遇到了“Model not found”的报错。社交平台上陆续有人反馈中招,到了当天晚些时候,仍有用户表示没有恢复正常。
连家底雄厚、资源充足的OpenAI都免不了掉链子,可见钱多、机器多,也不能保证服务从此不出故障。
从OpenAI到
比如,同样是写报告,以前让AI起草一段文字,回答完就结束了。现在把一批文件交给Agent,它得先读材料、提取数据、整理内容、检查结果,发现问题还得反复修改。
同一个用户,只是换了一种用法,背后消耗的Token数量就可能相差很大。用户只发了一条指令,后台可能已经触发了多轮模型调用。
这么一来,即使用户总数没有显著增加,服务器承担的计算量也可能大幅上升。模型越好用,用户越敢把复杂任务交给它,原来勉强够用的算力,就可能再次吃紧。
但偏偏在这个紧要关口,
首先是算力和基建的“远水救不了近火”。
前面提到的千亿融资仍在推进,乌兰察布的大型数据中心尚在建设,16万颗华为AI芯片也属于部署计划。从资金到账、设备采购,到机房通电、调试上线,中间还需要时间。但用户不会等机房建好了再来调用模型。
更麻烦的是,任务越来越复杂,
与硅谷大厂动辄数千人的规模相比,
今年9月,Harness团队开放了约150个工程岗位,重点补充服务端开发和Agent弹性计算。团队负责人崔添翼提到,数据、机器和容器、训练与评测任务、Agent运行环境,以及用户和请求量,都在急剧增加。他也曾直言,团队“工作繁重,仍然非常缺人”,自己每天都在面试。
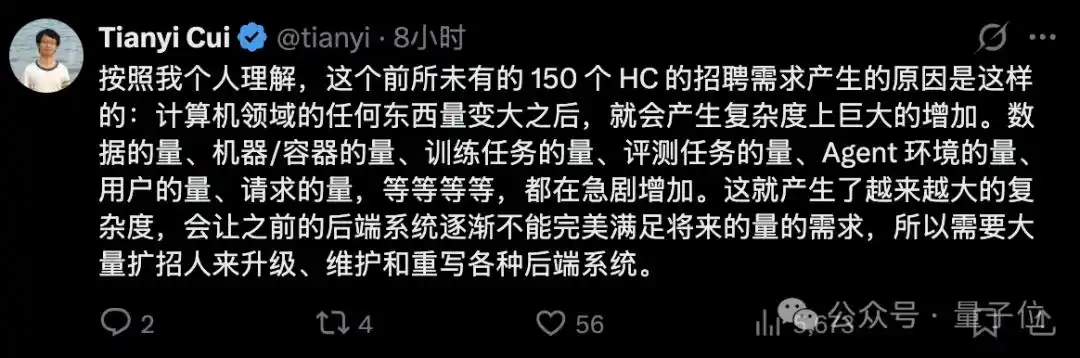
但招人、升级系统都需要时间。
而且对
全球只有5000人,见过顶尖AI
一个非常反常识的事情是,尽管
前特斯拉AI总监、OpenAI早期成员Andrej Karpathy,最近就给出了一组反差鲜明的估算。
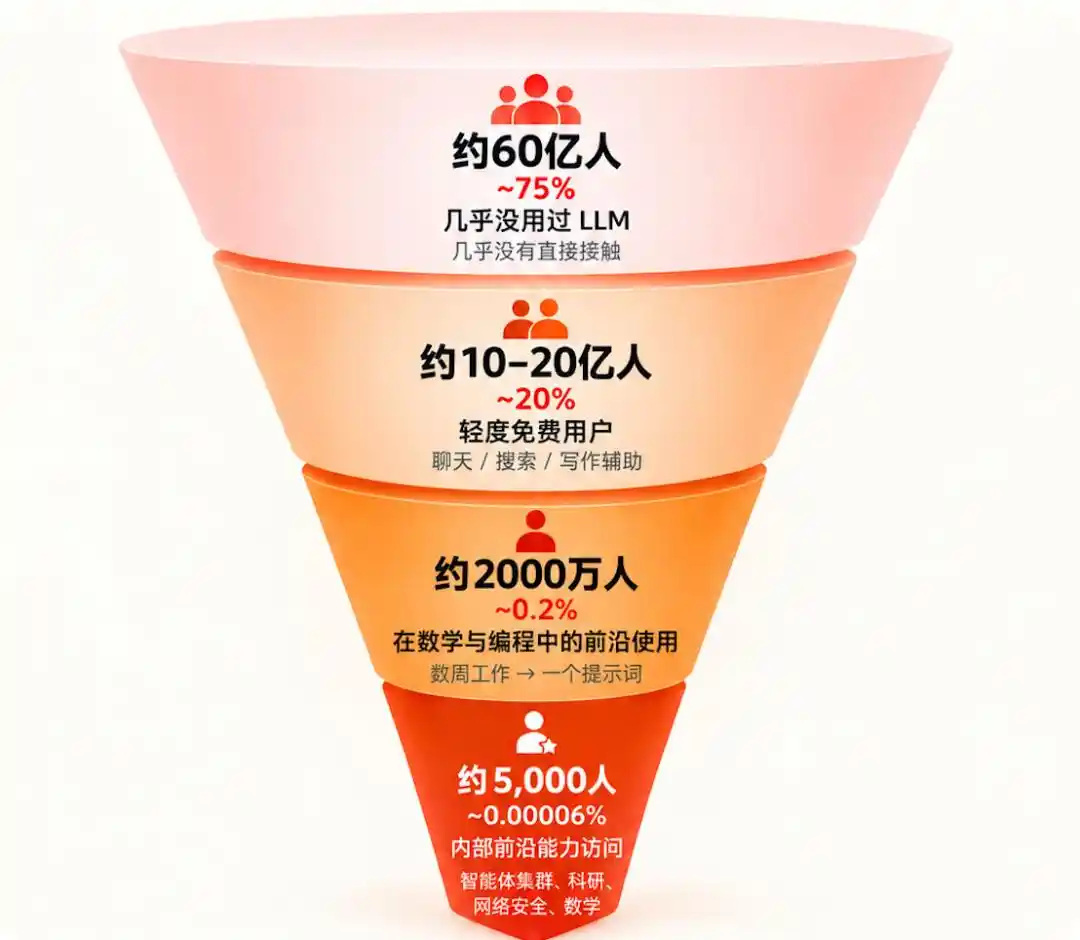
按照他的粗略估算,目前全球仅有约5000人,能接触到最先进的内部AI系统,看着AI智能体协作处理大型软件项目、开展网络攻防、探索数学和科学边界。
往下看,约2000万人已经在数学、编程等领域专业使用前沿模型,让Agent完成过去需要几周甚至几个月的工作。
而大约10亿至20亿人,只是偶尔使用ChatGPT等免费产品的轻度用户。对他们来说,AI更像一个聪明些、方便些的搜索引擎,写写文案、搜搜资料就是主要用法。
至于大约60亿人,几乎没有接触过大模型。这场被硅谷寄予厚望的技术变革,对他们而言,可能还只存在于另一个世界里。
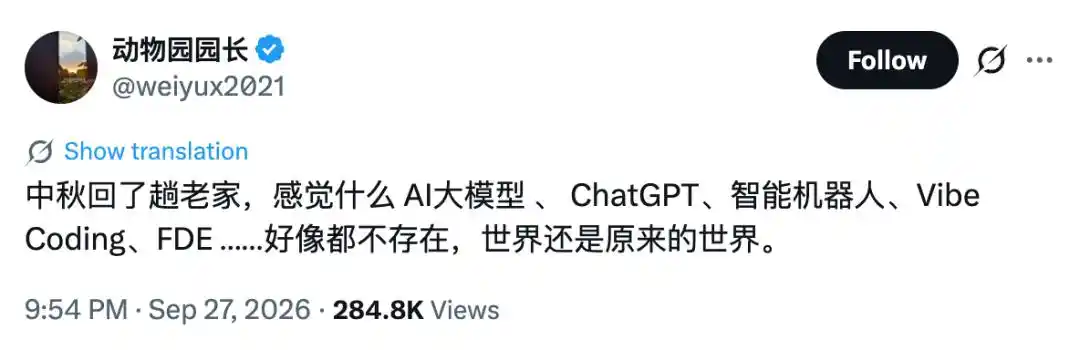
这也难怪,刚过去的中秋和国庆假期,有网友回老家后感慨:只要离开工位,什么大模型、具身智能、Agent,都从生活中消失了,日子还是原来的日子。
可假期一结束,坐回格子间,我们又立刻被扑面而来的新工具包围。
对还没用过大模型的人来说,
这也让围绕AI泡沫的争论,多了一点值得琢磨的地方。
现在就有人开始断定AI的真实需求已经被提前透支,可能还是太早了。
已经在用的人,还在尝试把更多工作交给AI;尚未用过的人,也可能随着产品变得更好用,开始加入其中。
千亿融资还在路上,
毕竟,模型再聪明,关键时刻掉链子,也只能算一个偶尔旷工的天才。
参考资料:
[1]财新:
[2]字母榜:大扩军之后,
[3]AI科技评论:
[4]财经杂志:
[5]晚点LatePost:V4发布前的
[6]量子位:OpenAI光速上新GPT-6.1 Sol!一晚上25项更新,都在这里了;
[7]APPSO:全球只有5000人能用上最强AI,卡帕西:80亿人正被加速甩开;
本文来自微信公众号“蓝字计划”,作者:周末
为你推荐

商务合作:TG:@Lottie96
Copyright 火星财经 All Rights Reserved.