


有预言家,A社研究蓝图曝光,Claude Code来自5年前
Anthropic公司2021年7月内部研究路线图意外曝光,显示其早在成立初期就已明确规划Claude Code、工具调用、AI自我评判、万亿参数模型、超长上下文及安全对齐等关键技术方向,印证其长期聚焦安全AGI与软件工程智能体的战略前瞻性。
 摘要由 Mars AI 生成
不er,A\你穿越回来的啊??
因为一起版权官司,Anthropic一份2021年7月的内部研究路线图,意外曝光。
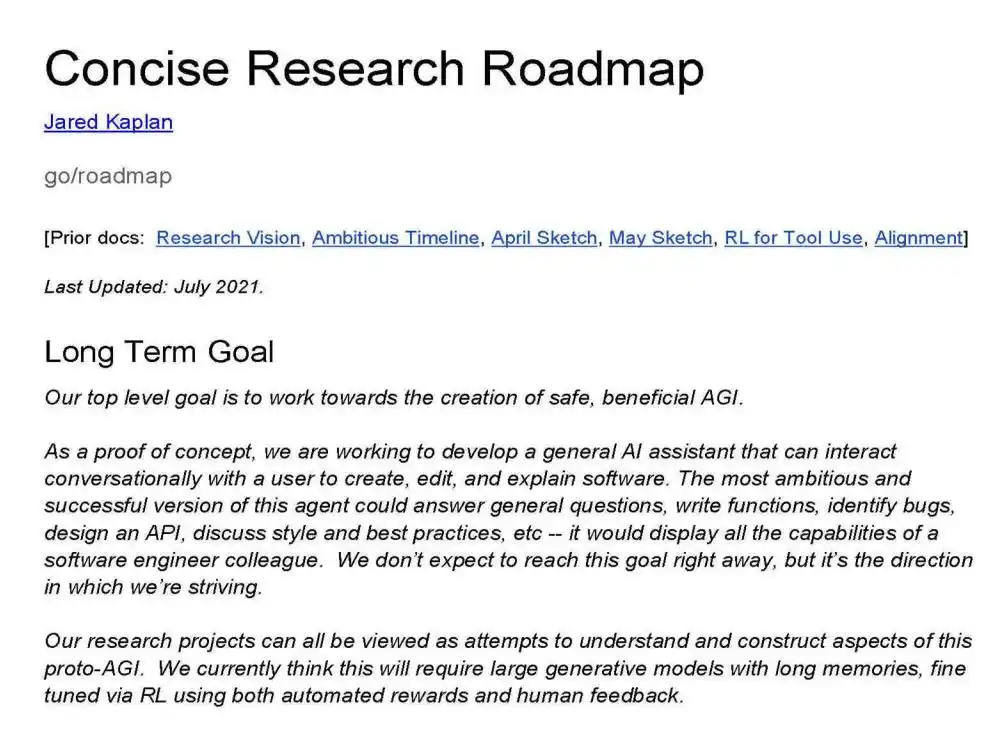
很短,PDF正文就两三页。
但把这份当时标着「最高机密」的文件从头读到尾,我瘫软了(bushi)。
今天的Claude Code、工具调用(Tool Use)、AI自我评判(Self-Judging)、测试时计算(Test-time compute)、甚至上万亿参数与超长上下文……
五年前,在这家公司刚刚从OpenAI独立出来几个月、全员只有十几个人的时候,就已经被白纸黑字写得清清楚楚。
5年前的路线图
很多人以为,大模型从聊天机器人走向写代码、操作系统的Agent,是这两年技术成熟后大家顺水推舟搞出来的。
错了。
在2021年这份路线图的最开头,Anthropic给自己的终极目标(Safe, beneficial AGI)立了一个非常清晰的原型定位:
做一个能通过自然语言跟人类交互,去创建、编辑和解释软件的通用AI助手。
什么叫通用AI助手?
能回答通用问题、写函数、找Bug、设计API、讨论代码风格与最佳实践。
最狠的是后面那句话:
它要展现出一个软件工程师同事的全部能力。
不是,我寻思,这不就是Claude Code吗??
在当时GPT-3刚火不久、大家还在惊叹AI能写藏头诗的时候,Anthropic就直接跳过了简单的代码自动补全逻辑,瞄准了完整的软件工程代理。
不仅如此,在具体实现路径上,内部还展开过一场极其精彩的争论。
研究员Andy Jones在批注里抛出一个核心分歧:我们到底该先做真正好用的编程助手,还是先去证明工具调用的可行性?
当时团队面临两条路:
实用路线:搞代码仓库检索(Repo Search),让AI能去翻项目的类型定义。
对了,GPT-3论文一作Tom Brown也参与了这个方向的讨论,建议从代码Repo Browsing入手。
然后是第二条——
研究路线:搞printf调试、编辑器操作,先证明模型能调工具。
最后是CEO Dario拍的板:
短期先验证工具调用的可行性,长期再演进成超级好用的编程助手。
现在回头看Claude Code的演化过程,完全是在照着Dario当年的这句话一步一步走。
Self-judging、万亿参数与超长记忆
除了Coding Agent,这份路线图里还有对底层技术的预判。
比如在预训练部分,2021年的他们就白纸黑字写下要训练1T(1万亿参数)及以上的超大模型,并且探索超长上下文(Very large contexts),或者其他能容纳海量记忆与经验的机制。
在那个175B还是庞然大物的年代,他们就已经把万亿参数和超长记忆当成了标配基建。
更绝的是在人类反馈与对齐(Alignment)部分。
文档里赫然写着:
模型自我评判。
2021年,他们就已经在研究,怎么让模型评估自己的行为和输出质量,怎么把模型自己的判断作为反馈信号。这正是今天AI Feedback以及推理模型自我纠错的核心思想。
更有意思的是,文档甚至出现了后来大模型研究中极其重要的一个概念:
Test-time compute(测试时计算)。
当然,当时这项研究被放在对齐和判别器研究的语境中,距离后来o1式的推理计算扩展还有相当距离。
但至少说明,早在2021年,Anthropic的研究视野就已经覆盖了模型训练之外的计算投入。
咱就是说,Neo Lab还是有东西的,怪不得Ilya会瘫软。
不知道现在的前沿实验室,每天又在经历些什么。
内部冷汗时刻
当然了,既然是A\\,避免不了谈论安全问题。
但我看了一下发现,这帮人是真爱讨论安全啊,花了好长的篇幅。
作为一家以安全立命的公司,Anthropic在2021年就预见到了今天Agent满地跑时面临的噩梦。
联合创始人Sam McCandlish在批注里提出了一个灵魂拷问:
怎么安全地部署没有沙箱隔离的工具?
Dario紧接着跟帖补刀:
具体来说,就是在部署时执行代码的Tool!
(ps:原文真的有感叹号,你的Dario就是这么激情澎湃)
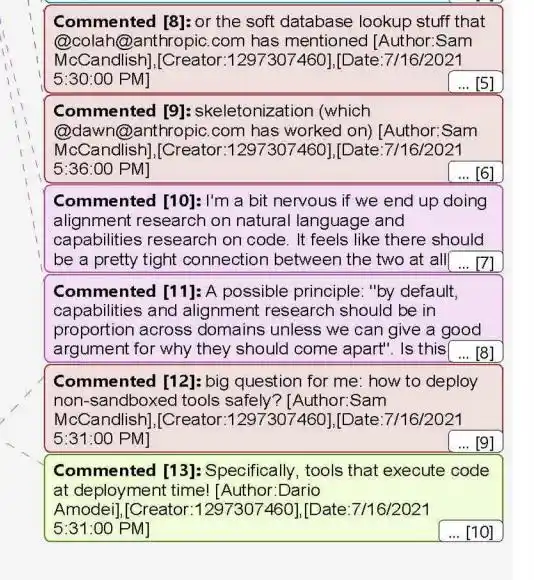
神了。
当AI真的能直接在宿主环境里运行代码、调用Shell、修改文件的时候,一旦失控或者被Prompt注入,后果简直不敢想。
今天全网在讨论的Agent提权、环境逃逸、数据污染,人家2021年就在讨论沙箱边界了。
可能确实因为他们一开始就想走这条路吧。
对了,Amanda在这份报告也出现了,就是前段时间比较火的一个A社内部哲学家。
她非常严肃地指出:
如果我们在自然语言上做对齐研究,却主要在代码上推进模型能力,我有点担心。这两种研究必须时刻保持紧密联系。
如果我们不在能力提升的领域做对齐研究,就会限制对齐测试的有效性。这可能会产生连锁反应,比如因为早期没有整合,对齐研究直接变成了一座孤岛。
甚至直接提议确立一条公司原则:
各个领域的能力研究和对齐研究应该成比例同步推进,除非我们能给出充分的理由说明为什么要分开。
One More Thing
唉,我就说A\\咋老压OpenAI一头啊,原来是先发优势。
Anthropic这五年是咬定青山不放松,死磕高质量代码信号、强化学习和企业工作流;
而OpenAI一路多线作战,做文生图、搞Sora视频、做语音助手、做搜索,多少分散了战力。
不过,就在大家还在复盘两家技术路线差异的时候,OpenAI那边突然曝出了一个比好莱坞电影还离谱的惊天大瓜——
家人们,OpenAI有内鬼啊!!!
根据美国联邦检察官公布的起诉书,35岁的OpenAI前产品团队工程师Abdulrahman Alfozan已被正式解雇并遭到联邦刑事指控。
这哥们儿干了啥?
他在OpenAI旧金山总部高管专用的核心会议室里,把一个带有高级加密和数据传输功能的窃听设备,用卫生纸包着,悄悄插在了电视机背后的USB接口上。
要知道,这个会议室是Sam Altman等高管开核心闭门会的地方,平时聊的全是超级智能研发机密、未公开产品规划和政府合作简报。
结果,这么容易就被人hack了。
世界真是个草台班子啊。。。
PDF:
https://i.smitop.com/concise-research-roadmap.pdf
本文来自微信公众号“量子位”,作者:Jay
为你推荐
商务合作:TG:@Lottie96
Copyright 火星财经 All Rights Reserved.