


All-In解读AI下一阶段:模型趋同,价值开始向工作流上移
AI行业正从模型能力竞争转向成本效率与工作流价值竞争,基础模型逐渐趋同并商品化,利润池向Agent、企业工作流、垂直应用和分发能力迁移,前沿模型需证明在科研、工程等高价值场景的不可替代性。
 摘要由 Mars AI 生成
原文标题: Anthropic IPO at Risk, Meta』s Muse Pop, Token Prices Fall, Open Source Gains Share, Alignment Fails 节目: All-In Podcast 参与者: Chamath Palihapitiya、Jason Calacanis、David Sacks、David Friedberg
原文作者:律动BlockBeats
原文来源:https://www.theblockbeats.info/news/63830
转载:火星财经
编者按:过去两年,AI 行业的竞争几乎一直围绕一个核心变量展开:谁拥有更强的基础模型。GPT、Claude、Gemini,以及随后快速崛起的 DeepSeek、Qwen 等模型,不断刷新 benchmark,也让「前沿能力」成为模型公司最重要的定价基础。但随着模型迭代速度越来越快、推理成本持续下降,讨论正在从「谁的模型最强」转向「当足够好的模型越来越多,最强模型还能值多少钱」。当模型能力逐渐从稀缺品变成一种更容易获得的基础能力,一个更关键的问题开始浮现:AI 产业真正长期稀缺的,到底是模型本身,还是建立在模型之上的产品、工作流与分发能力?
最新一期 All-In Podcast 中,科技创业者 Jason Calacanis、Social Capital 创始人 Chamath Palihapitiya、Ohalo CEO David Friedberg,以及 Craft Ventures 联合创始人 David Sacks,围绕近期密集的模型发布、开放权重模型扩张、Token 价格下降,以及 Anthropic、OpenAI 等前沿模型公司的商业模式展开讨论。相比「下一代模型又提升了多少性能」,这场对谈更值得关注的地方,是它试图回答模型能力快速扩散之后,AI 产业的利润池可能向哪里迁移。
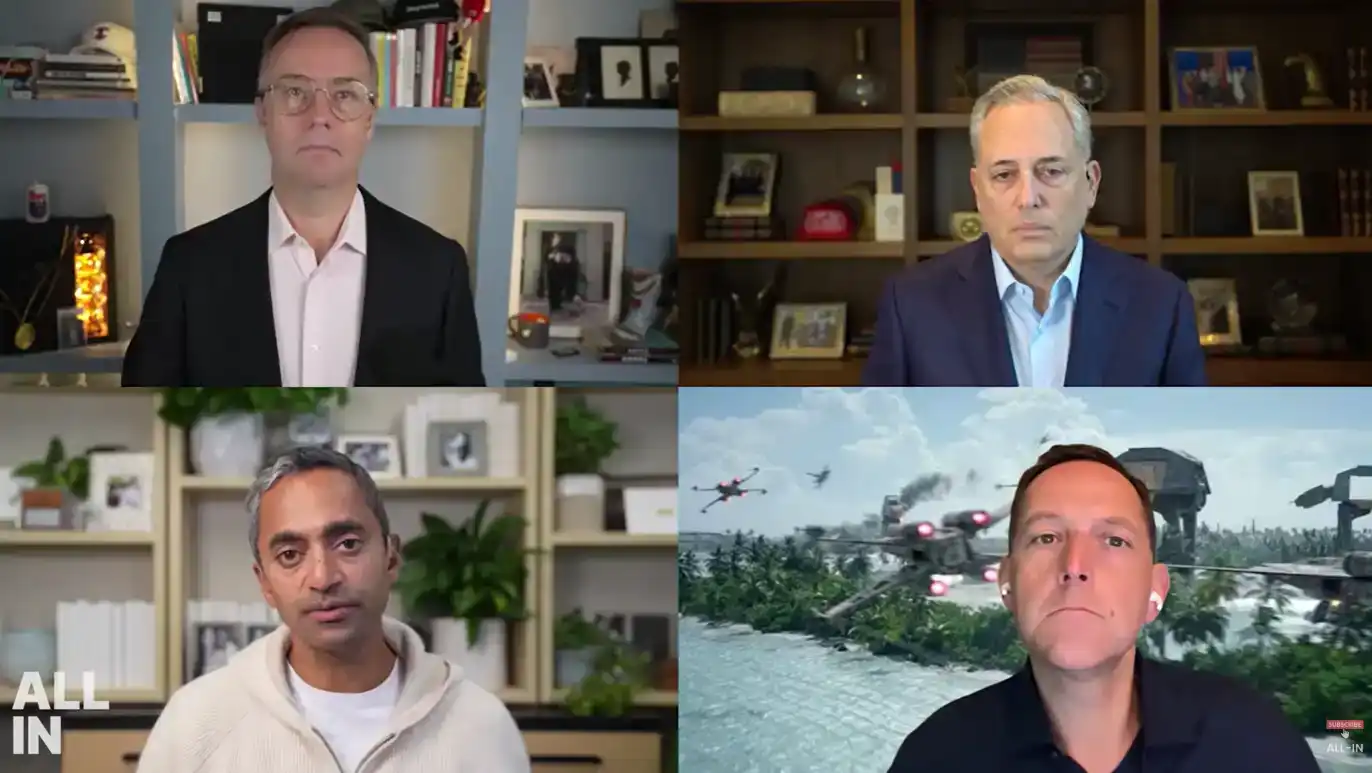
All-In Podcast 四位主持人围绕 AI 模型商品化、开放权重模型与前沿模型商业模式展开讨论。
在这场对谈中,几位主持人实际上是将「模型越来越强」拆解成了一组更底层的结构性问题:当模型之间的性能差距缩小,企业为什么还要支付前沿模型的高溢价?当开放权重模型能够承担越来越多日常工作负载,Token 本身是否正在走向商品化?以及当「大脑」越来越便宜,价值是否会向 Agent、企业工作流和垂直应用重新集中?
第一,是模型竞争正在从能力稀缺转向成本效率。过去,最先进模型与第二梯队之间往往存在明显能力差距,企业为了获得更高准确率、更强推理和更稳定的输出,愿意支付显著溢价。现在的变化是,模型发布越来越密集,开放权重模型的性能持续逼近闭源前沿模型,而 API 厂商本身也在不断降价。这意味着,对大量并不要求极限能力的任务而言,「最好」正在从刚需变成一种可以计算投入产出比的选择。模型性能依然重要,但价格与性能之间的比值,开始比单纯的 benchmark 排名更重要。
第二,是 Token 可能正在从高毛利产品变成标准化基础投入。过去一轮 AI 商业化的逻辑相对直接:模型公司提供 intelligence,开发者购买 Token,再在外部封装成应用。但当同一类任务可以在多个模型之间迁移,而且价格差距达到数倍甚至数十倍,企业自然会把不同任务分配给不同成本层级的模型。简单摘要、客服、内部流程和普通代码任务可以交给廉价模型,只有科学研究、复杂工程、高价值金融决策等少数任务继续调用最强模型。这里真正受到挑战的不是前沿模型有没有价值,而是究竟有多少收入必须依赖前沿能力才能成立。
第三,是模型公司的竞争边界正在被迫向上移动。Chamath 将基础模型比作「大脑」,而把围绕模型构建的工具调用、浏览器、记忆、权限和任务规划系统称为 harness。这个区分很重要:当「大脑」之间的差距不断缩小时,最终决定产品体验的可能越来越不是模型本身,而是它有没有「手脚」,能不能真正完成任务。Meta Muse 一类 Agent 产品因此具有另一层意义——用户并不关心背后调用哪个模型,而关心它能不能整理邮件、订机票、处理文件和完成工作。基础模型越便宜,这类产品的经济性反而越容易成立。
第四,是前沿模型的商业模式可能因此走向两极化。一端是规模巨大但高度价格敏感的通用智能,由开放权重模型和低成本模型承接;另一端则是数量更少、但愿意支付极高溢价的 Frontier Intelligence,例如复杂科研、数学、工程、生物医药和高度竞争的专业场景。OpenAI、Anthropic 等公司的关键问题因此不再只是「还能不能继续提升模型」,而是能否证明最先进模型创造的增量价值足以长期覆盖其更高的训练、推理和资本开支。
如果将这场对谈压缩为一个判断,那就是:AI 的核心矛盾正在从「智能够不够强」,逐渐转向「智能如何被定价、分配和产品化」。
在这个意义上,本文讨论的对象已经不只是 OpenAI、Anthropic 或某一款新模型,而是整个 AI 产业价值链的一次重新定价:当模型本身越来越容易获得,真正稀缺的资产,可能重新变成用户、场景、工作流,以及把智能转化成实际价值的能力。
以下为原文内容(为便于阅读理解,原内容有所整编):
TL;DR
AI 模型竞争正从「谁最强」转向「谁更便宜地达到够用水平」,本质是模型能力开始从稀缺品走向标准化供给。
Token 价格持续下探,意味着基础模型本身的利润空间可能被压缩,AI 价值链正在从「卖智能」转向「卖结果」。
开放权重模型最大的冲击不是取代前沿模型,而是接管大量通用工作负载,迫使企业重新计算「最强模型溢价」是否值得。
前沿模型未来更可能集中在科研、工程、金融等高价值复杂任务,关键不在覆盖所有场景,而在证明其不可替代性。
模型能力越趋同,竞争优势就越向 Agent、工具调用、记忆、权限和工作流迁移,本质上是价值从「大脑」转向「执行系统」。
企业 AI 成本结构将从「统一调用最强模型」转向分层路由,不同任务匹配不同价格和能力层级的模型。
OpenAI、Anthropic 的核心商业风险不是模型停止进步,而是大量现有收入最终被更便宜的模型商品化。
下一阶段 AI 行业真正稀缺的可能不再是模型本身,而是用户、场景、分发和把智能转化为实际产出的能力。
视频要点
模型还在变强,但更重要的是:它们正在变便宜
过去几年,AI 模型竞争有一个非常清晰的逻辑:谁拥有最强模型,谁就拥有稀缺性。
GPT、Claude、Gemini 每次跨越一个能力台阶,都足以带来一轮新的产品和资本叙事。模型性能差距足够大时,企业愿意为「最强智能」支付明显溢价。
但 All-In 认为,这套逻辑正在变得复杂。
Friedberg 在节目中列举了近期一连串模型更新。虽然自动转写中的部分型号和发布日期存在误差,但背后的趋势并没有错:模型更新正在变得极其密集,而且性能提升与成本下降正在同时发生。
例如,DeepSeek 9 月 10 日发布 V4.1 Flash。这是一个 5520 亿参数的 MoE(Mixture of Experts,混合专家)模型,但输入时只激活约 80 亿参数,输出时激活约 160 亿参数。DeepSeek 同时下调了 API 价格,并称新的 KV Cache 设计将显著减少显存和存储需求。
OpenAI 也在往同一个方向走。9 月 22 日推出的 GPT-6 Sol 和 Luna,相比此前 GPT-5.6 的推广价格,API 价格分别降低约 50%。
Anthropic 同日推出 Claude Opus 5.5。其每百万 Token 的输入价格从 Opus 5 的 5 美元降至 4 美元,输出价格从 25 美元降至 20 美元;对于 Agent 场景中使用频率很高的 Cache Read,价格则从 0.5 美元降至 0.2 美元。Anthropic 称,综合 Token 使用效率计算,典型任务运行成本可以下降约 40%。
单独看,每一家公司的降价都可以解释为架构优化或规模效应。放在一起看,信号更加明显:AI 智能本身正在经历快速的价格压缩。
开放权重开始抢量,Token 正在变成「商品」
价格下降之外,还有另一个变化正在发生:越来越多工作并不一定需要最贵的模型。
这里需要先区分一个经常被混用的概念。节目中多次使用「open source」,但严格来说,open-weight(开放权重)并不完全等于 open-source(开源)。前者通常意味着模型权重可下载、可自行部署,但许可证、训练数据或完整训练代码未必完全开放。
对于企业而言,商业含义却很直接。
如果一个内部摘要、客服分类、代码辅助或者常规 Agent 工作流,可以用一个便宜十倍的模型完成到足够好的程度,那么继续调用最昂贵的 Frontier Model(前沿模型),就会越来越难向 CFO 解释。
Vercel 的 AI Gateway 数据已经出现类似趋势。其 9 月发布的 Production Index 显示,在 Vercel AI Gateway 处理的 Token 中,开放权重模型占比已经从 2025 年 12 月的 7% 上升至今年 8 月的 56%,首次超过一半。
与此同时,平均 Token 成本已经降至五个月前的一半以下,仅 8 月一个月,单位 Token 价格又下降 23.2%。
这里需要强调:这是 Vercel AI Gateway 的生产流量数据,不能直接外推成「全球 56% 的 AI Token 已经来自开放模型」。但它至少提供了一个真实生产环境中的样本:开发者开始越来越频繁地把工作负载迁移到更便宜的模型。
Chamath 将这一变化概括为「模型开始 clustering」。他的判断是,越来越多模型在大量任务上的能力已经接近到足以互相替代。于是问题不再只是「哪个模型最高分」,而是:为了最后那一点性能差距,你愿意多付多少钱?
前沿模型不会消失,但必须证明自己「贵在哪里」
这也是 OpenAI 和 Anthropic 面临的真正商业问题。
David Sacks 在节目中的观点比其他几位主持人更乐观。他认为,开放权重模型即使拿走绝大多数 Token,也不意味着 Frontier Intelligence(前沿智能)失去商业价值。
原因是总会存在一批任务,对「最好」有极高支付意愿。例如药物研发、复杂数学、尖端工程、网络安全,或者高度竞争的金融交易场景。对于这些任务来说,如果更强的模型能够提高一点成功率,它创造的经济价值可能远远超过 Token 成本。
Friedberg 也持类似看法。他所在的生命科学研发组织会使用 Anthropic 的模型,因为在一些高难度科学任务上,模型能力差异仍然足够大。
因此,真正值得关注的并不是「开放模型会不会消灭 Claude 或 GPT」,而是一个更加具体的问题:OpenAI 和 Anthropic 的收入中,有多少来自真正不可替代的前沿任务,又有多少来自最终可以迁移到廉价模型的普通任务?
如果绝大多数收入来自前者,模型公司仍然拥有很强的定价权。但如果大量收入只是因为企业暂时习惯使用最强模型,那么随着企业优化 AI 成本,这部分收入可能面临越来越大的价格压力。
这也是为什么模型公司的客户结构和收入质量,未来可能比单纯的 Token 增长更值得观察。
从资本市场角度看,这一点尤其重要。投资者真正需要判断的,不只是「Claude 或 GPT 还能不能继续增长」,而是这种增长背后的前沿智能溢价到底有多持久。
当「脑」越来越便宜,价值开始转移到「手脚」
Chamath 在节目中提出了另一个更值得关注的判断。如果把模型看成「大脑」,真正决定最终产品体验的,正在越来越多地变成包裹在大脑之外的 agent harness(智能体执行框架)。
所谓 harness,可以理解为让模型真正「做事情」的整套系统,包括浏览器、工具调用、记忆、任务规划、权限管理、代码执行以及与不同软件连接的能力。同样一个模型,装进不同的 harness,最终表现可能完全不同。
这意味着,当基础模型逐渐趋同时,AI 公司竞争的重点可能开始向上移动一层。
过去的核心问题是:谁有最聪明的模型?接下来可能越来越变成:谁能让这个模型真正完成工作?
Meta 的 Muse 正是这一趋势的一个代表。
Meta 9 月 8 日发布 Muse,把它定位为 personal AI agent(个人 AI 智能体):它不只是回答问题,而是能够通过独立的虚拟计算环境操作浏览器和应用,完成发送邮件、安排旅行等任务。
节目中,Chamath 提到自己用 Muse 整理私人邮箱,也尝试让它订机票和酒店。他认为,这类产品最重要的意义不是底层用了哪一个模型,而是它把原本复杂的 AI 能力包装成普通用户可以直接使用的软件。
这也解释了为什么 Token 价格下降未必意味着 AI 行业价值缩水。相反,更便宜的智能可能让更多产品变得经济可行。模型层赚得更薄,并不等于整个 AI Stack 赚得更少。价值只是可能从模型本身,重新分配给拥有用户、工作流和最终产品的公司。
AI 下一轮竞争,可能不再是谁的模型第一
这场变化仍处于早期阶段。
前沿模型与开放权重模型之间依然存在能力差异,不同 benchmark 也远不能代表所有真实企业任务。All-In 所提出的「模型正在收敛」,目前更适合被理解为一种商业判断,而不是已经完成的行业事实。
但价格变化已经更加明确。开放权重模型正在进入越来越多生产环境,API 单价持续下降,闭源模型厂商也在主动降价。与此同时,Meta Muse 等产品开始尝试把 AI 从聊天窗口推向真正可以执行任务的 Agent。
接下来真正值得观察的,已经不只是下一代 GPT 或 Claude 在 benchmark 上又提高了多少分。
更重要的是四个变量:
第一,开放权重模型在真实生产 Token 中的占比能否继续提高;第二,单位智能成本还能下降多快;第三,高价前沿模型能够保住多少不可替代的复杂任务;第四,Agent 能否真正形成稳定使用频率和商业收入。
如果前三个趋势继续发展,AI 模型可能越来越像云计算中的基础算力:仍然重要,但价格不断透明、标准不断统一。
而真正决定下一阶段公司价值的,可能不再只是「谁拥有最聪明的大脑」。而是谁能把越来越便宜的大脑,变成真正有人愿意使用和付费的产品。
[视频链接]
为你推荐
商务合作:TG:@Lottie96
Copyright 火星财经 All Rights Reserved.