



光进铜退进行时:新华三全栈光互连提前卡位之后才是真考验
文章聚焦AI算力网络升级背景下‘光进铜退’趋势,分析光互连技术从可插拔模块、LPO、NPO到CPO的演进路径,强调新华三在全栈光互连领域的提前布局与技术领先性,包括全球首款51.2T 800G CPO交换机、1.6T 224G互通实测及自研光引擎等,指出连接已成为制约算力释放效率的关键变量,而真正考验在于技术落地与真实集群验证。
 摘要由 Mars AI 生成
速率每翻一倍,铜缆能可靠传输的距离就减半。112G时还有两米左右,到224G只剩一米上下,而AI算力集群的互联距离需求,只会更长。当电信号在铜缆里逼近物理极限,光成为算力网络继续向前的必经之路,这就是业界所说的“光进铜退”。更准确地说,它不是路线站队,而是带宽、功耗和距离共同作用下的工程结果。”
过去一个多月,这场换代密集落子:8月14日,英伟达宣布其 Spectrum-X 硅光交换机进入全面量产;9月11日,新华三联合多家光模块与器件厂商完成1.6T 224G链路的互通实测;9月17日,华为发布采用近封装光学(NPO)的昇腾 960 超节点,用5500个自研光引擎替代了原本约4.8万颗800G光模块。把这些动作叠在一起看,AI算力网络的换代已经越过是“会不会发生”的讨论阶段,剩下的只是节奏与路径。
而在设备商一侧,新华三的布局更早,也更宽:早在 2023年6月,它就发布了全球首款51.2T 800G CPO硅光数据中心交换机。三年间,从LPO、CPO到NPO,从器件、设备到组网调优,光互连的几条主要路线与关键环节,它都比行业早一步落子。
瓶颈转移:连接正在成为算力的关键变量
大模型参数正从万亿级向十万亿级演进,算力集群的规模也从千卡走向万卡、十万卡。集群越大,芯片之间的连接对系统效率的权重就越高。新华三给出的一组数据把这种权重量化了出来:在智算数据中心的整体投资里,网络占比约为10%,但网络性能波动可导致训练效率下降30%、训练时长增加25%;以千卡规模的H100集群为例,每天的停机成本超过30万元。投入占比不高,系数影响却极大,这正是连接环节近年来被产业反复重估的原因。
市场的增长曲线更为陡峭。据LightCounting测算,AI驱动的以太网光模块与共封装光学(CPO)市场,规模将从2025年的约165亿美元增至2026年的约260亿美元,同比增长约60%。连接之于算力的角色,已经从此前的配套环节,变成决定算力释放效率的关键变量。
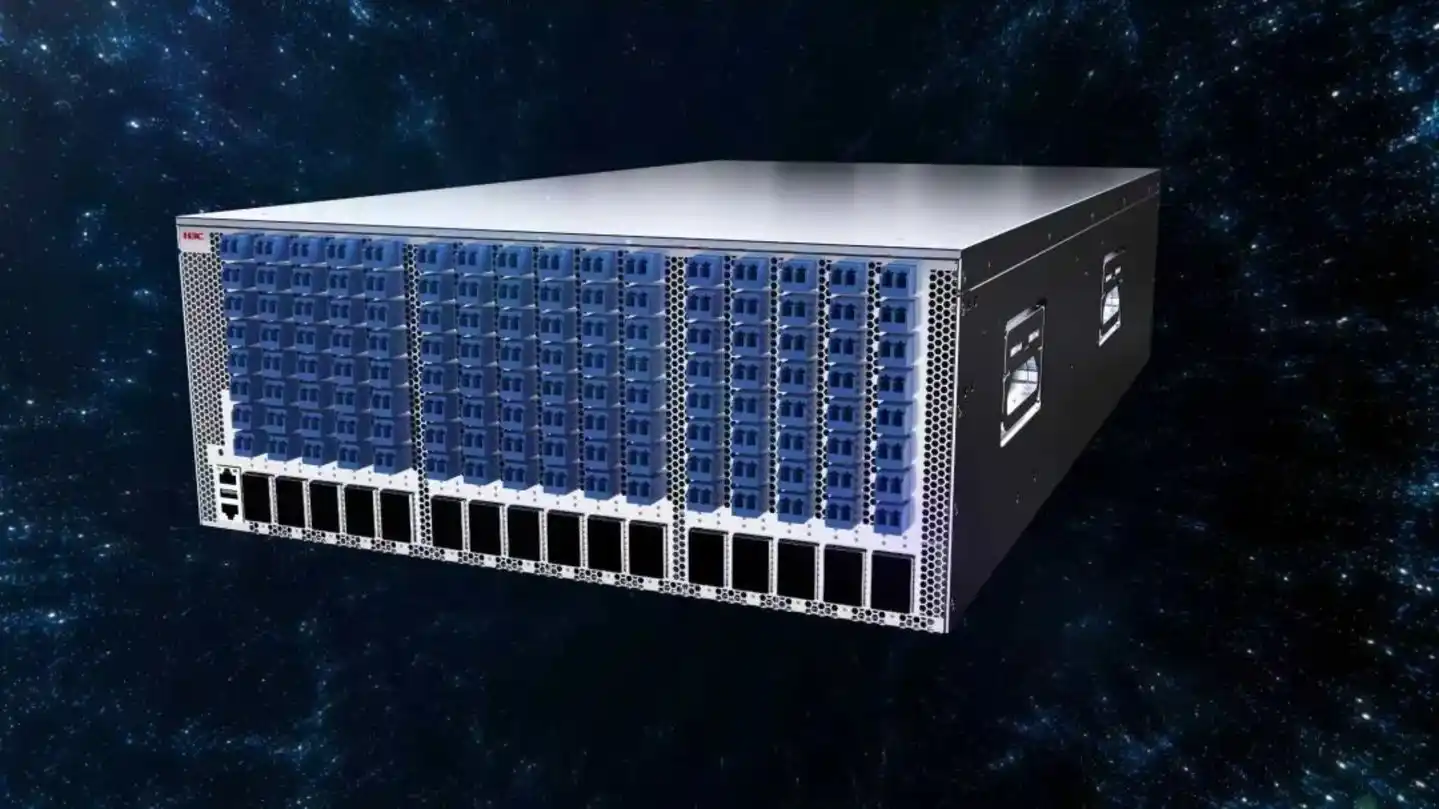
行业习惯用“试点年、放量年”来标记光互连的节奏,但新华三的入场比这份时间表还早了三年。2023年新华三发布全球首款单芯片51.2T 800G CPO硅光交换机——H3C S9827-64EO,比国际主流厂商提前近两年推出,标志着CPO技术在产品化方面实现重大突破。该交换机单芯片带宽高达51.2T,支持64个400G/800G端口,融合CPO硅光技术、创新散热与智能无损网络设计。目前,新华三800G CPO硅光交换机产品已具备量产与商用交付能力。2026年5月,新华三在最新一届领航者峰会上创新性发布全系列单芯片102.4T智算交换机,该系列引入CPO/NPO(共封装光互连)、CPC(共封装铜互连)等最新技术,精准匹配机柜内、机柜间不同算力互联场景。
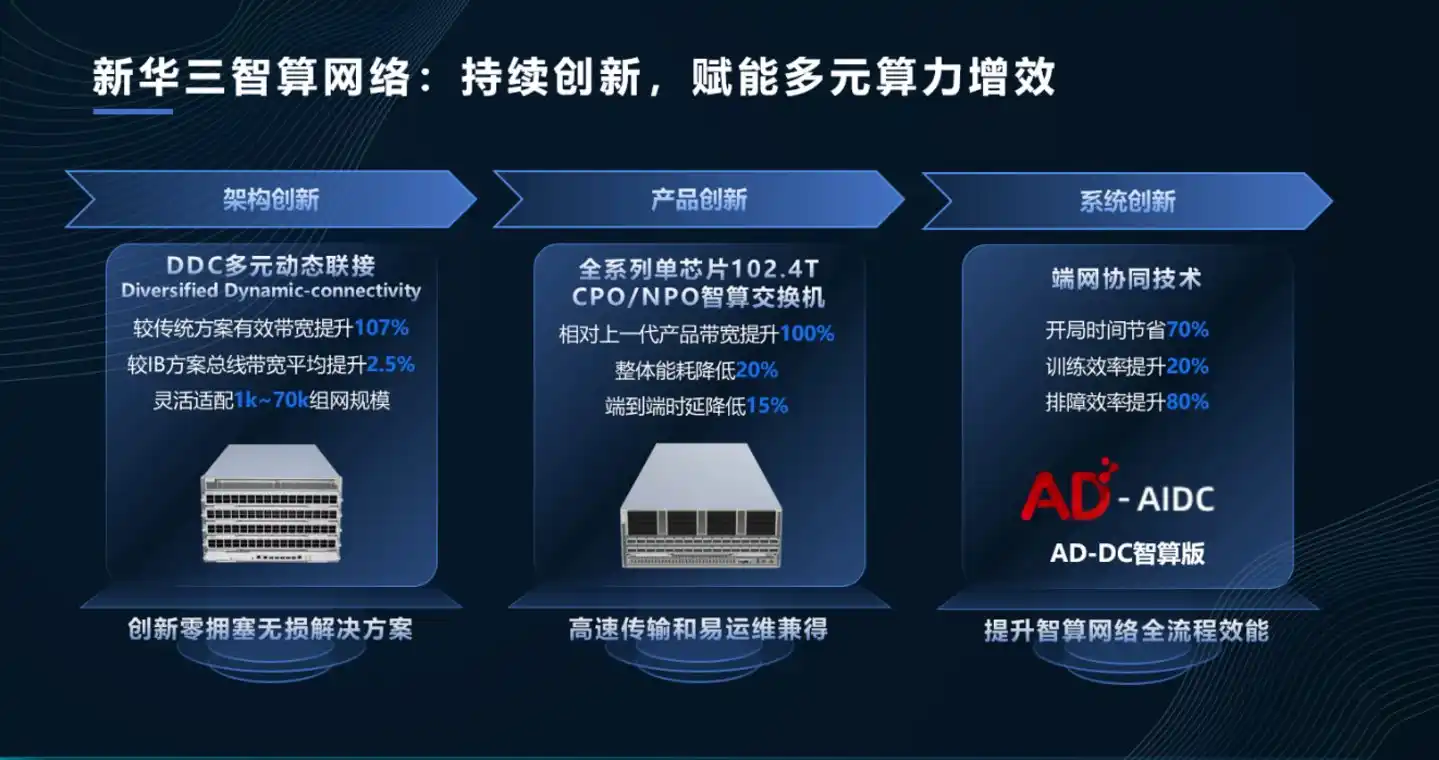
更重要的是,新华三在光互连上的布局不止于单点产品。CPO与NPO,是光引擎向芯片靠近的两种形态;LPO与可插拔光模块,保留着模块化与可维护性的空间;全光交换等更远的方向,也在前瞻布局之列。对一家以交换机为基本盘的设备商来说,这样的跨度并不常见:光模块曾是模块厂商的领域,而新华三把链条一路向上游延伸,落到了光引擎这样的核心环节。
光在一层层靠近芯片
回看光互连的形态变迁,路径相当清晰:最早是可插拔光模块,插在交换机面板上,维护方便,代价是电信号要穿过长长的板级走线;随后是把光引擎挪到交换芯片旁边的近封装光学(NPO),电信号的传输路径被大幅缩短;再往前一步是CPO,光引擎与交换芯片封装在一起,光电转换被推到离计算核心最近的位置。形态每向芯片靠近一步,能效与密度的收益更明显,工程难度也更高,到了CPO,散热、良率与维护的挑战已经摆上台面。面对这道难题,新华三的应对是把“可替换”设计:支持外置光源、光引擎、主控等关键组件灵活替换,并通过内置光链路智能诊断与预测,在能效与运维便捷性之间取得平衡。
在新华三集团高级副总裁、网络产品线总裁乔剡看来,CPO与NPO只是同一颗光引擎的两种形态:封进芯片里是CPO,放到芯片旁边是NPO,真正的主角是那颗负责光电转换的光引擎。
这条路径背后还有供应链的推力。乔剡提到,当前光互连供应链上最紧俏的两个环节,一个是激光器,一个是DSP芯片;而硅光走的是CMOS逻辑工艺,对先进制程产能的依赖更小,为高速光互连提供了一条更易扩展的供应路径。
对这场替换的性质,新华三认为 “光进铜退”不是立场之争,而是带宽演进的客观结果。铜缆不会彻底消失,它将更多保留在设备带外管理、机柜内极短距离等特定场景,而高速互联会是光的绝对主流。
方向确定之后,真正的变量变成了节奏,而在乔剡的判断里,这个节奏是并行与渐进的:一部分成熟场景会长期停留在以电为主的速率段,而最前沿的速率向 224G、448G 演进时,光会成为必然选择,率先完成全光化的,是最先进的那批算力设施。他把这个过程比作燃油车与新能源车的更替:路上的存量还在跑,新上牌的大多已是新能源。
面对这种渐进,新华三给出的路径是“光电并行”:机柜内用电互联保障可靠性与成本优势,机柜间用光互联突破密度与功耗瓶颈,并在不同场景中选择最优介质。
产业侧的日程表也在印证这种渐进。行业的普遍判断是:2026年是小规模试点年,2027年迎来规模放量的拐点,2028年逐步走向大规模交付。近期密集推进的 NPO生态就是样本:腾讯计划今年四季度部署NPO超节点、2028年实现规模化,阿里云计划年内试点部署3.2T NPO系统、再逐步放量。标准层面,中国信通院已牵头近50家单位成立NPO标准工作组,推动各家方案从分头探索走向统一标准。产业链层面,中国厂商占全球光模块市场约七成份额,为这类新路线的落地提供了产业纵深。
另一边,可插拔光模块并未退场:LightCounting在近期报告中提示,NPO是当下讨论的焦点,但可插拔仍是市场出货的主力。从可插拔、LPO到NPO、CPO,多条路线会按场景与成本长期共存,各自找到最适配的场景。光与电的交接,会比单点新闻呈现的速度更漫长。
从单点产品到全栈实践
在这轮换代里,设备厂商能交付的方案,正从单一产品扩展为一套从器件到组网的连接体系——角色也不再止于光模块的采购与集成。新华三给出的答案,是覆盖“卡间—机间—集群间”的全栈光互连,并把“光电并行、算网调优、广域无损”作为三大技术创新方向。据IDC今年上半年的数据显示,其在中国企业网交换机市场的份额为 33.3,持续位居第一。
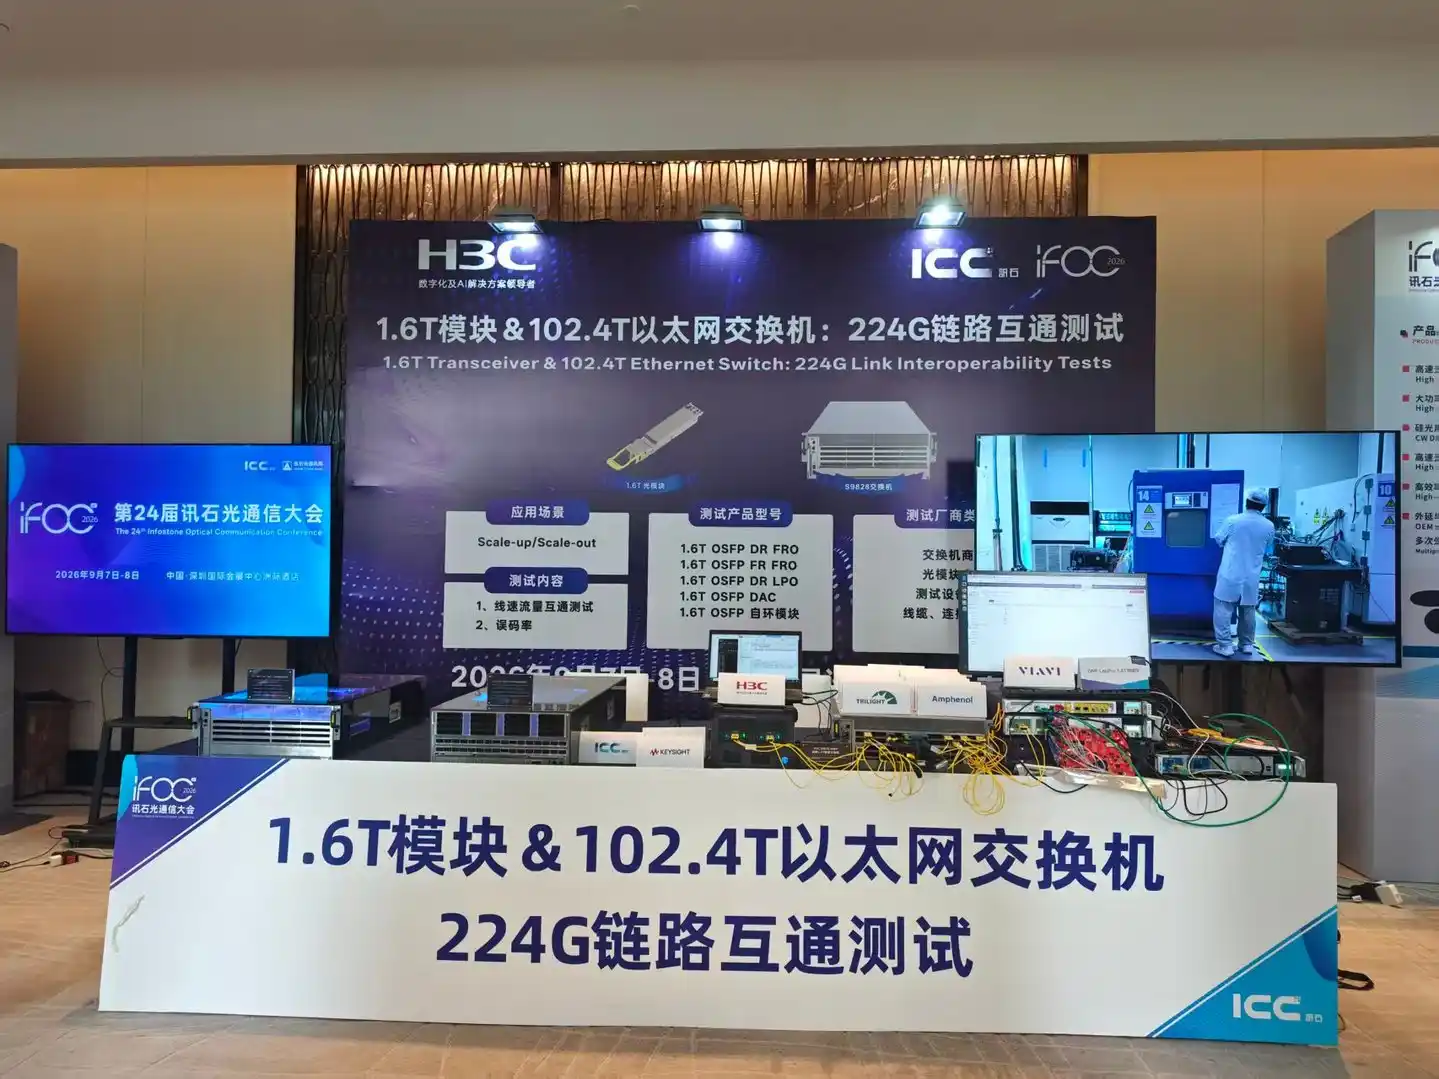
这条体系的最新一次检验,是今年9月那场1.6T 224G多厂商互通实测:S9828与多品类1.6T光模块、高速铜缆及链路器件稳定对接,64个1.6T端口、512条 224G高速通道满带宽运行,全程零丢包。据新华三方面介绍,这是业界首次1.6T 224G链路互通实测。
这场实测的另一层意义在于开放:测试把十余家供应商、多品类的器件放进同一张网络,检验多厂商环境下的协同与稳定。从800G高速光模块的互操作测试,到CPO直连光模块的公开演示,再到这次的1.6T满带宽实测,新华三在光互连上反复做的一件事,是让多厂商兼容成为可复现的工程结果。
支撑这些动作的,是光引擎等核心环节的持续投入——在供应持续紧张的当下,关键环节的自主程度直接关系交付节奏。据新华三方面介绍,基于自研 CPO/NPO 光引擎技术的产品已具备商业化交付能力,其中800G CPO硅光交换机已在互联网厂商完成技术验证与部署,LPO 方案也已在多家头部互联网企业与省级算力枢纽完成规模化部署;而这一代设备商的竞争,也在从硬件参数转向系统能力,组网、运维与调优的能力,正成为光互连真正落地的一部分。
全光互连还有多远
当光接管了传输,产业的下一个目标就是让光接管交换:以OCS(光电路交换)为代表的全光交换,试图用光开关矩阵替代部分电交换,让数据以更低的功耗和时延在集群内流转。
谷歌是这一路线目前唯一实现大规模商用的企业,门槛不仅在硬件,更在软件:光开关的调度需要与不同GPU的通信库、算子深度配合。这也解释了新华三为何与国内多家GPU厂商保持紧密合作:它把OCS的落点放在软件侧——调度能力要与这些厂商的通信库、算子深度适配,光交换才能真正运转起来。
速率演进也没有停在原地:3.2T的光互连进入客户验证,448G的下一站,也已写进标准组织与各家厂商的路线图。这场换代的方向由物理规律决定,节奏则由场景与生态共同决定。1.6T的商用验证已经开始,光还会继续向芯片靠近,快慢或有不同,方向已无悬念。对入场最早、铺得最全的新华三而言,真正的考验不是时间差,而是把提前铺好的每一段路,放进真实运行的集群里完成验证。
为你推荐

商务合作:TG:@Lottie96
Copyright 火星财经 All Rights Reserved.