


被硅谷吹爆的Jev到底有什么用?我们替你亲手试了试
文章实测AI工具Jev在信息查证场景中的应用,演示其通过Choice(多选分类)、Score(可信度评分)、Noul(是非判断)三大能力,对科技新闻进行自动分类、可信度评估与事实核查,并结合Python实现新闻审核自动化流程,强调其低门槛、网页即用、无需代码即可上手的特点。
 摘要由 Mars AI 生成
文|蓝字计划,作者|Chester
AI圈的一个“奇行种”,突然爆红。
9月15日,TypeSafe发布了Jev。几天后,它已经出现在Vercel、Cloudflare、LangChain、Langfuse等开发者工具里。Vercel说,Jev接入AI Gateway后的24小时内,接近13% 的付费团队就用上了它。
不过AI圈的东西看着神通广大,很多人都跃跃欲试,但真的到了想自己上手的时候,很多人还不知道该从哪儿开始。要下载什么?得先配置环境吗?不会写代码能不能玩?
因此,我们趁着现在还能免费体验,先替大家吃一次螃蟹:上手体验一把Jev ,并尽量教会让大家无脑用上Jev。
但在开始前,不得不说,测试下来Jev的第一道门槛比想象中低。 就像以前的OpenClaw,我们还说过它的配置要求低,未来说不定连智能手表都能带动。
而Jev的第一次体验更省事,甚至不用打开电脑,在网页端都能用上。
另一方面,我们这次挑选的体验案例也和大部人上网冲浪的真实需求息息相关。随着AI大爆发,社媒上到消息也开始鱼龙混杂起来。哪些是真消息?哪些是胡说八道?哪些是AI编造的?
以前大家不可能每条都去核实的“消息鉴定”步骤,这次我们打算把它交给Jev。
用Jev打造“火眼金睛”
目前能玩到Jev的入口已经有不少,比如我们这次就找了个第三方网站Jev AI Dev,几种基本功能都能在这里试,每个账号每天还有六次免费体验额度,比较适合大家先熟悉一下。
网址放在这里:https://jevai.dev/zh-Hans/playground/
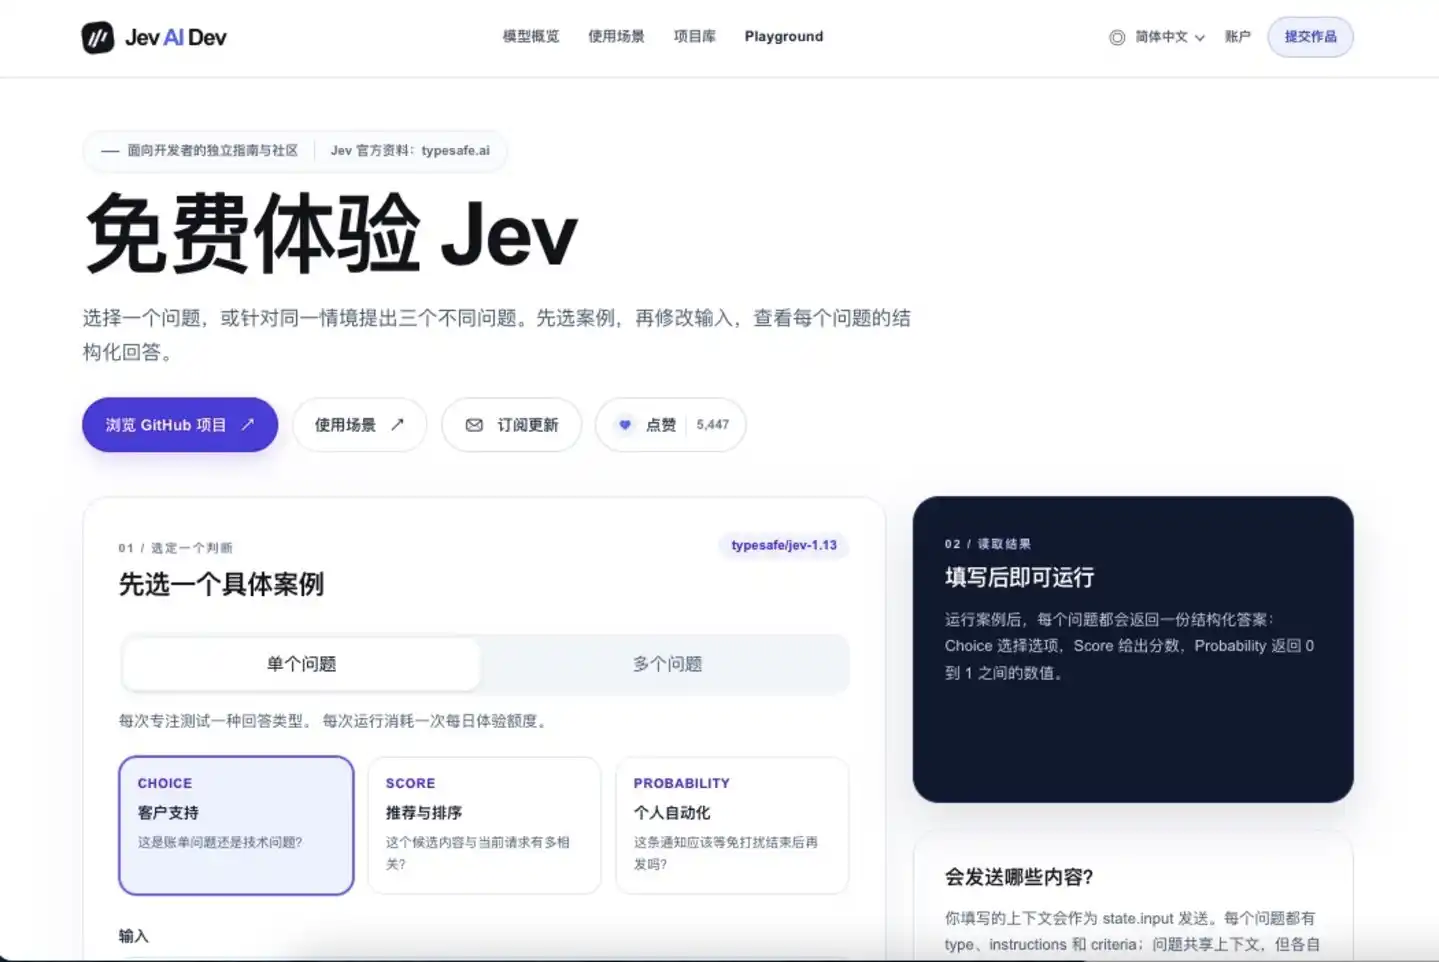
点开这个链接,就会进入中文试玩页面。先点击右上角的“登录”,按提示登录账号,然后往下找到“单个问题”和“多个问题”。
这两个选项,可以理解成拿着同一份材料,只问一件事,还是一次问好几件事。比如给Jev一条科技新闻,我们可以只让它判断“这属于哪类新闻”,也可以顺便问问“消息有多可信”“里面的说法有没有得到证明”。
既然要做一个信息查证的工具,我们这次就选“多个问题”,就可以对一条消息同时问几个问题。
继续往下看,可以看到页面默认会填好一套“AI助手任务交接”的示例。我们可以直接在这套示例上修改,把里面的内容换成自己的。
先找到“输入”框,删掉原来的示例文字,填入这条消息。
“9月23日,一家AI公司发布新模型,声称其代码能力比上一代提升30%,但目前只公布了宣传材料,没有公开完整测试数据。”
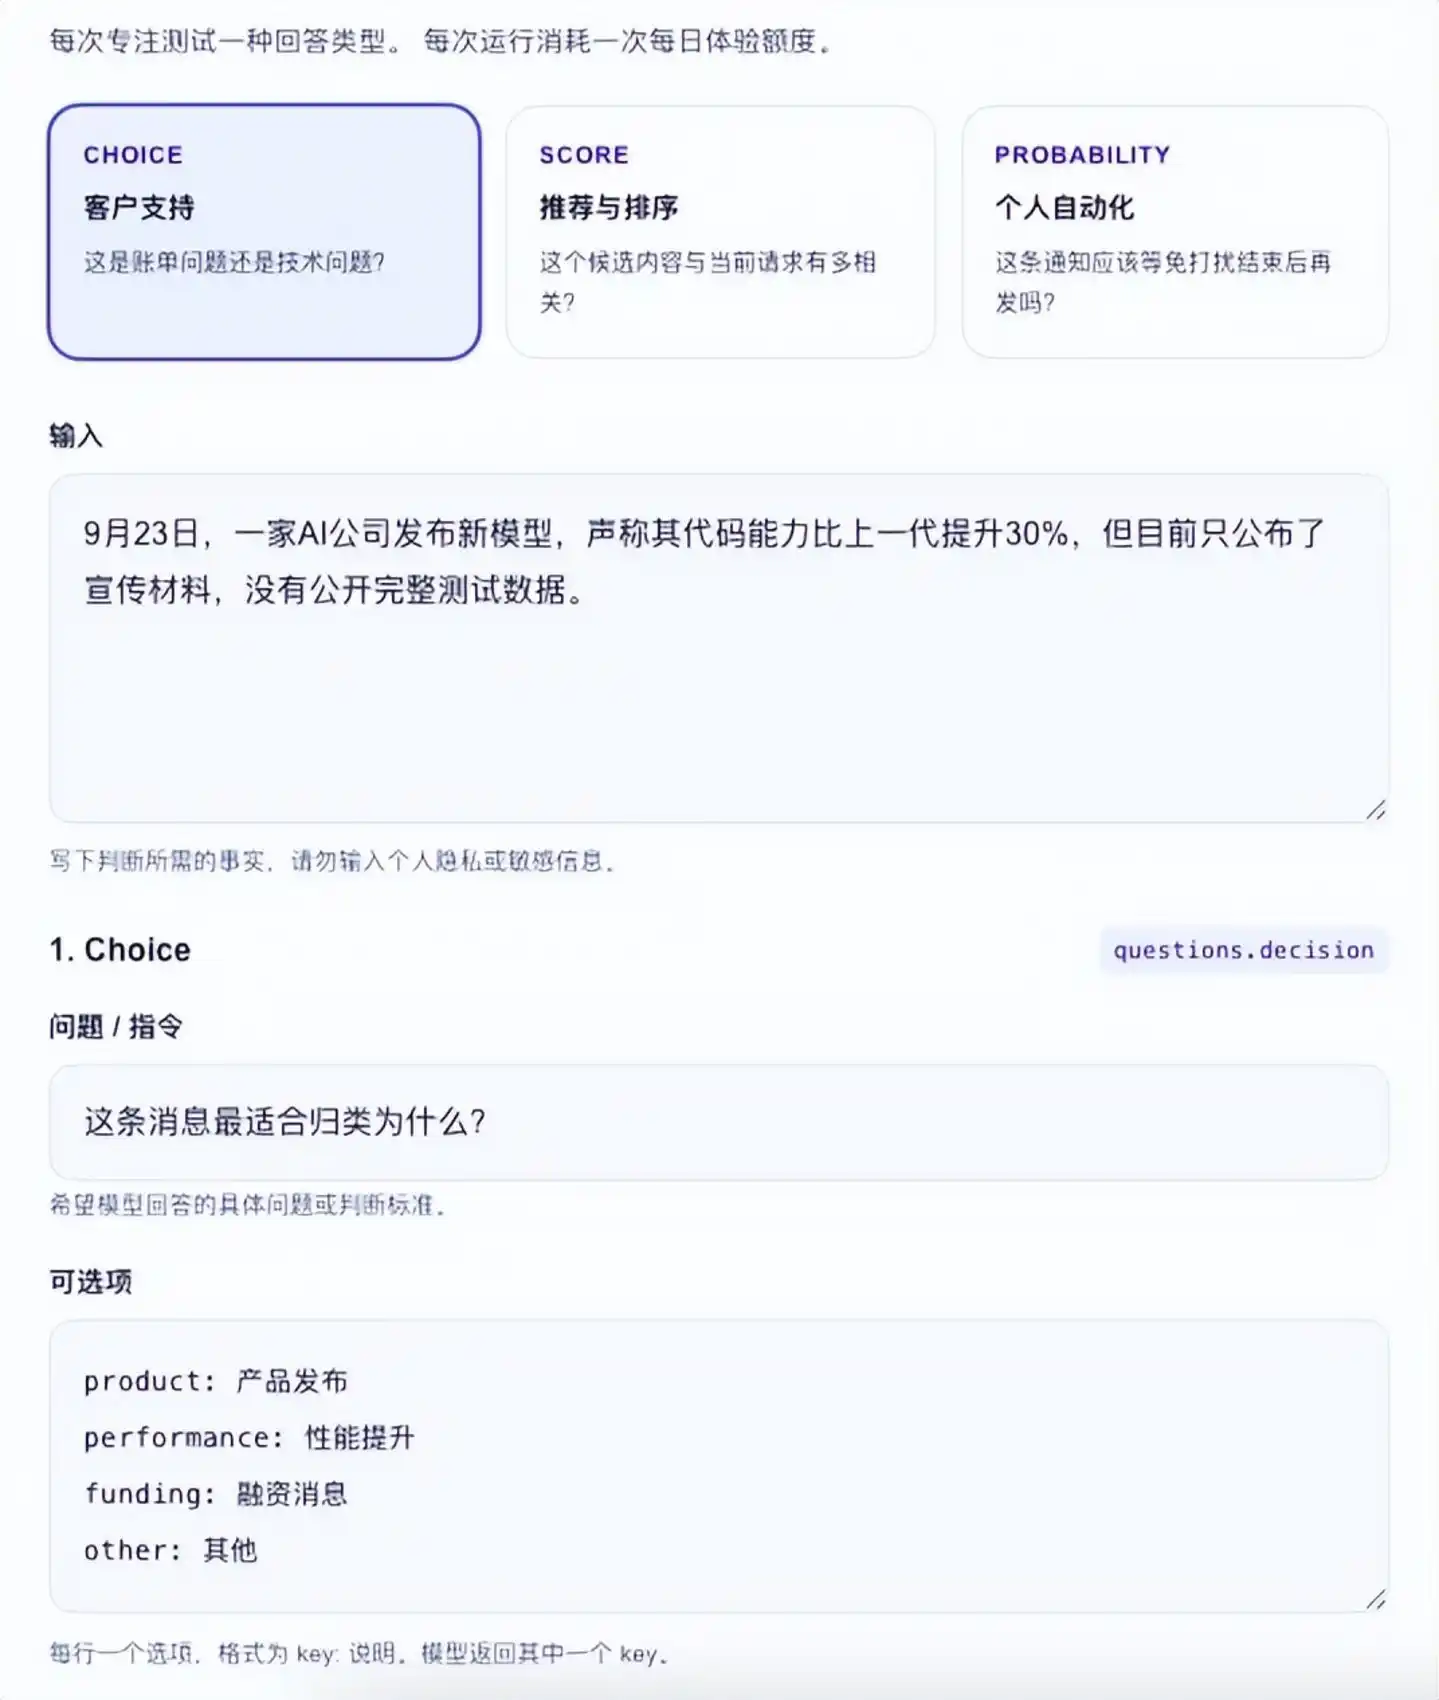
然后就可以直接体验Jev的三种能力:Choice、Score和Noul。虽然名字看起来挺面生的,但是用起来之后,还是挺好理解的:
Choice就是让Jev在几个答案里选一个。比如我们给它设置几个选项,让它判断一条内容下一步应该怎么处理。提交之后,它会告诉我们选了哪个答案,同时给出每个答案的概率。
比如我们想给这条新闻分类,就得先告诉它有哪些类别可以选。在Choice下方的“问题 / 指令”里,填入“这条消息最适合归类为什么?”
这时可以把“可选项”框里原来的内容替换成下面这四行:
- product: 产品发布
- performance: 性能提升
- funding: 融资消息
- other: 其他
假如Jev最后返回product,就表示它判断这条新闻的分类是“产品发布”。 这样,我们就给Jev出好了一道选择题。
它会从这四个答案里选一个,同时给出每个答案的概率,让我们看到它有多倾向于各个选项。
Score则是打分。分类只能告诉我们这是一条什么消息,但没法告诉我们该有多相信它,所以就需要多一个评分系统来辅助。
在Score的“问题 / 指令”里,填入“这条消息的可信程度有多高?”
下面的“评分等级”需要我们自己设置。这里每行填一个等级,按照从低到高的顺序排列:
- 很低
- 较低
- 中等
- 较高
- 很高
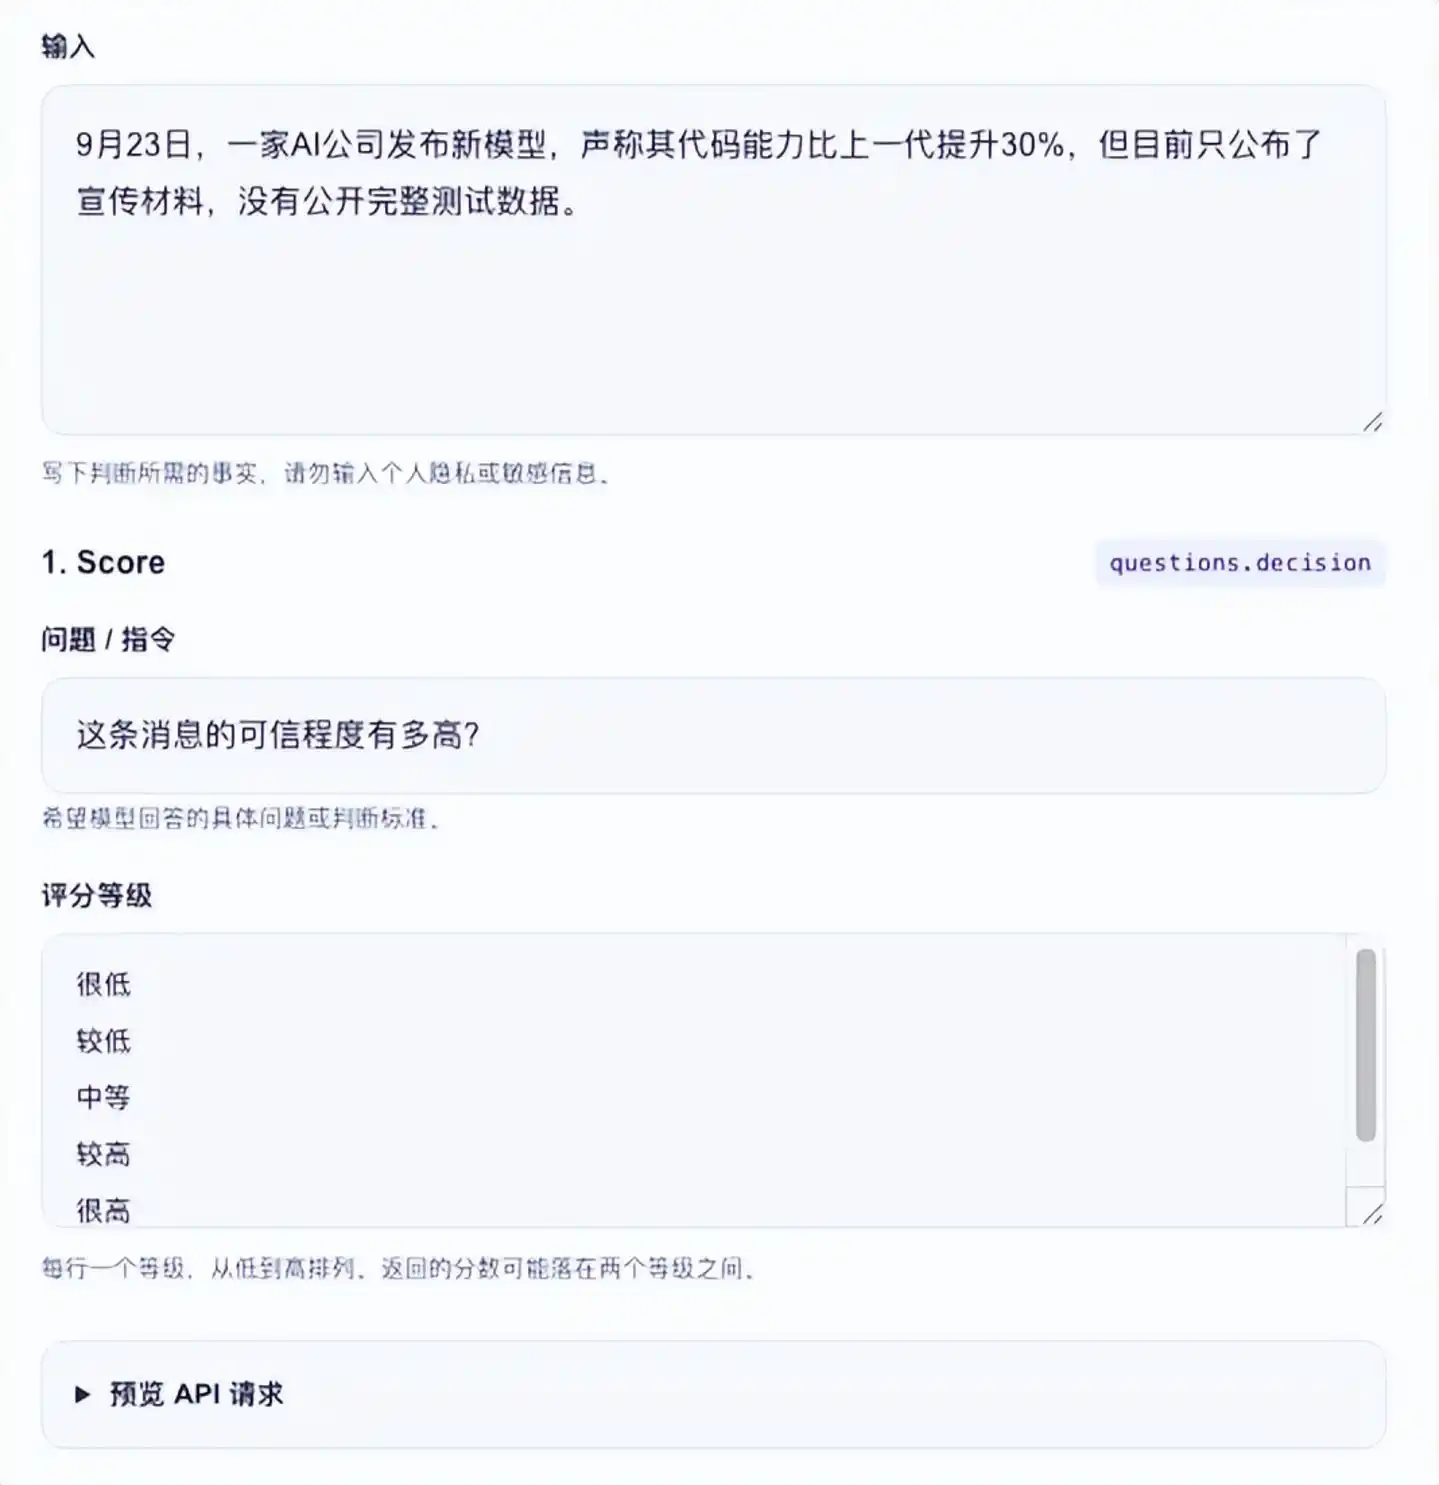
这时,我们相当于给了Jev一把打分的尺子,判断输入的材料的可信度到底有多高。
最后是Noul ,可以简单理解成回答“是或者不是”。 网页上这一栏叫“Probability (Noul)”。
有时候,我们可能还想多了解一下比“可信程度有多高”更具体的情况。就拿我们原本想问的这个问题为例子,我们也许会好奇,公司说代码能力提升了30%,到底有没有拿出证据?
那么在这一栏的“问题 / 指令”中填入“这家公司是否已经证明新模型的代码能力比上一代提升30%?”,再把下面“‘否’与‘是’的定义”改成这两行:
- false: 没有证明
- true: 已经证明
到这里,三个问题就都设置好了。再来复习一下,通过这一轮设置,我们让Jev给同一条消息分个类、打个分,再判断其中的性能提升说法有没有得到证明;再点击下方的“体验Jev”,就把三个问题给提交了。
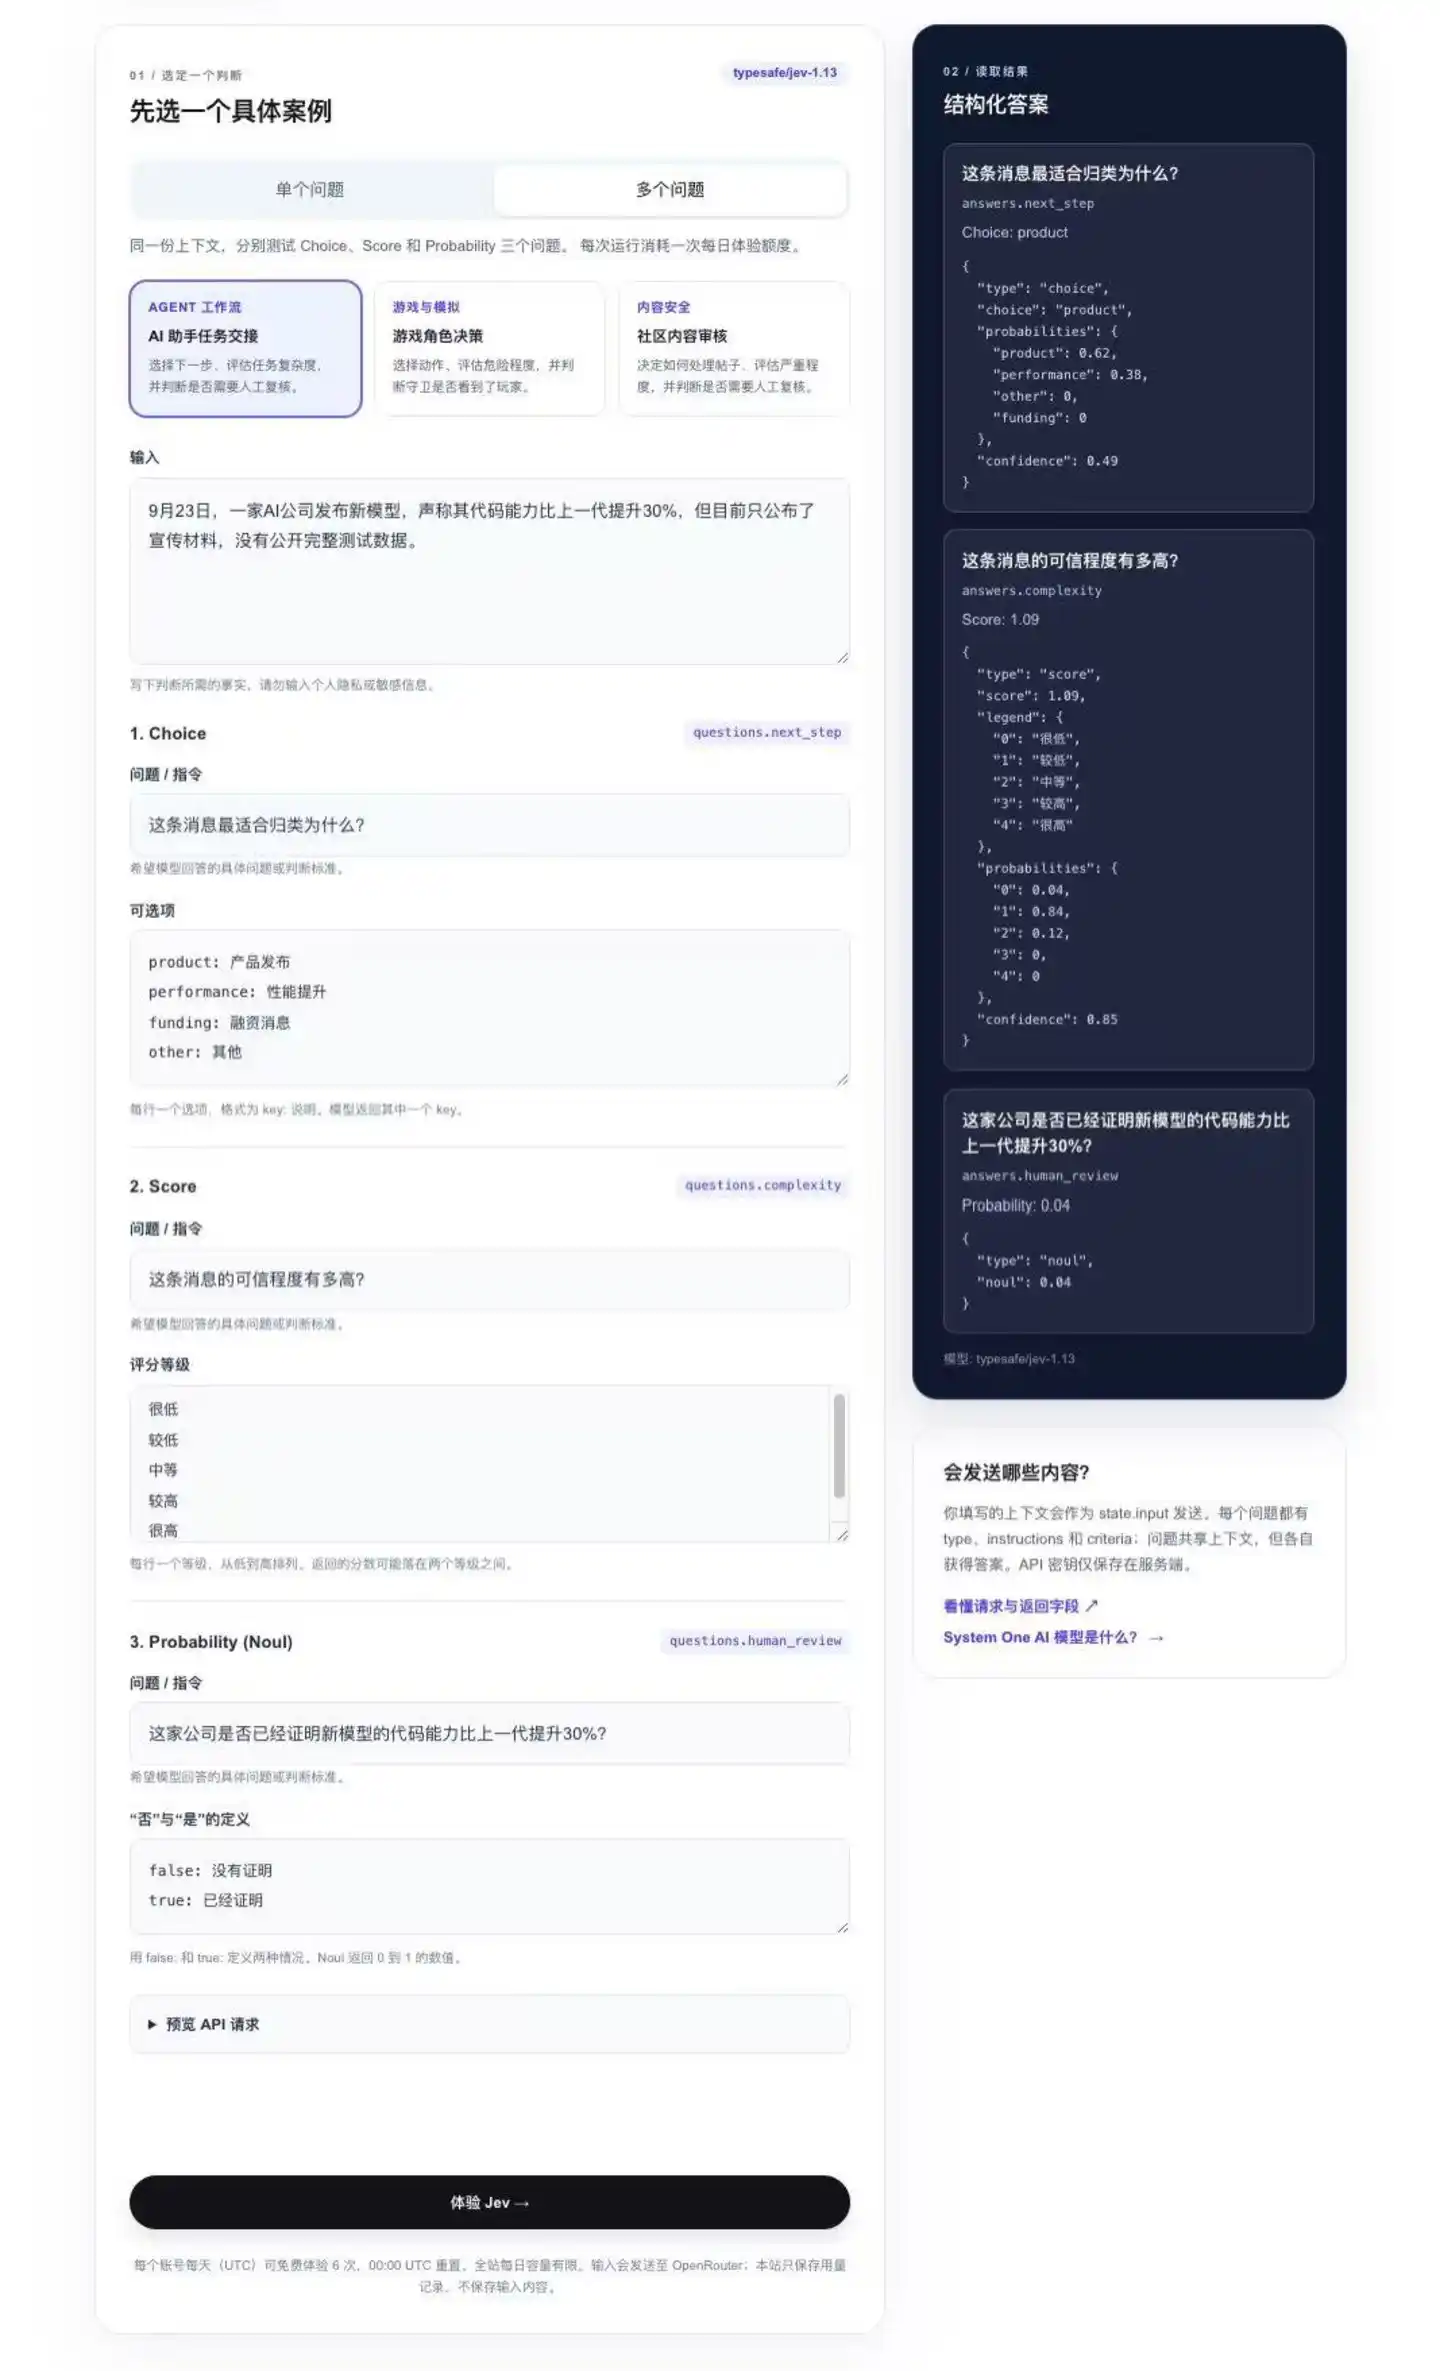
因为这次测试是运行在网页端,无论是电脑还是手机,都可以看到Jev返回的结果。
最终可以看到,Choice选择了product,也就是“产品发布”,对应的概率为0.62。“性能提升”的概率为0.38。它判断这是一次产品发布。
Score给出的分数是1.09。对照刚才设置的五档,这次结果接近“可信程度较低”。
Noul的结果则是0.04,说明根据我们提供的材料,它倾向于认为还没有证明。
在这一波流程后,Jev已经给出了它的初步判断:一条消息就有了分类、可信程度评分,以及针对具体说法的判断。但是它的依据只是我们填进去的文字,它并没有替我们上网找到完整测试报告。
于是,我们继续往下测。想要真正实现一个自动判断真伪的工具,还得让Python直接调用Jev,让它帮我们搭一个科技新闻的自动审核流程。
全自动,手搓审核工具
我们在Jev的Playground主页下方,找到了AI模型聚合平台OpenRouter。注册并登录账号,创建API Key后,就可以在Python中调用Jev了。
这里创建普通的OpenRouter API Key就可以,不需要另外申请Jev专用的。
另外,前面第三方网站每天六次的免费体验额度,不会带到OpenRouter,运行前需要确认账号里有可用额度。
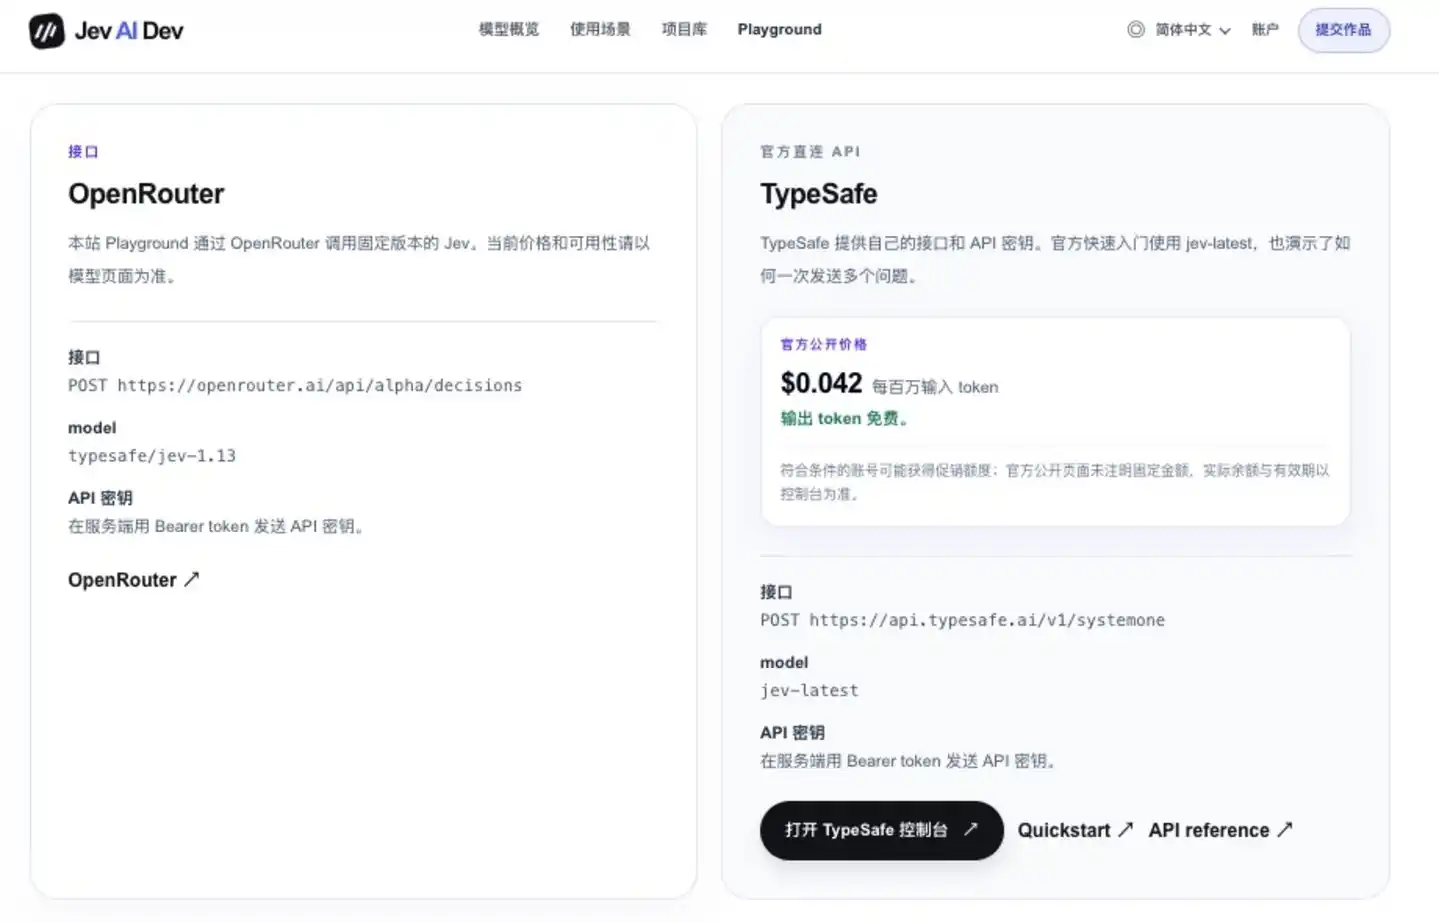
接下来,我们需要在程序里填好要判断的新闻、想问的问题,以及可以选择的答案。这和前面在网页里填表是一样的,只是提交和接收结果的工作,现在交给Python来完成。
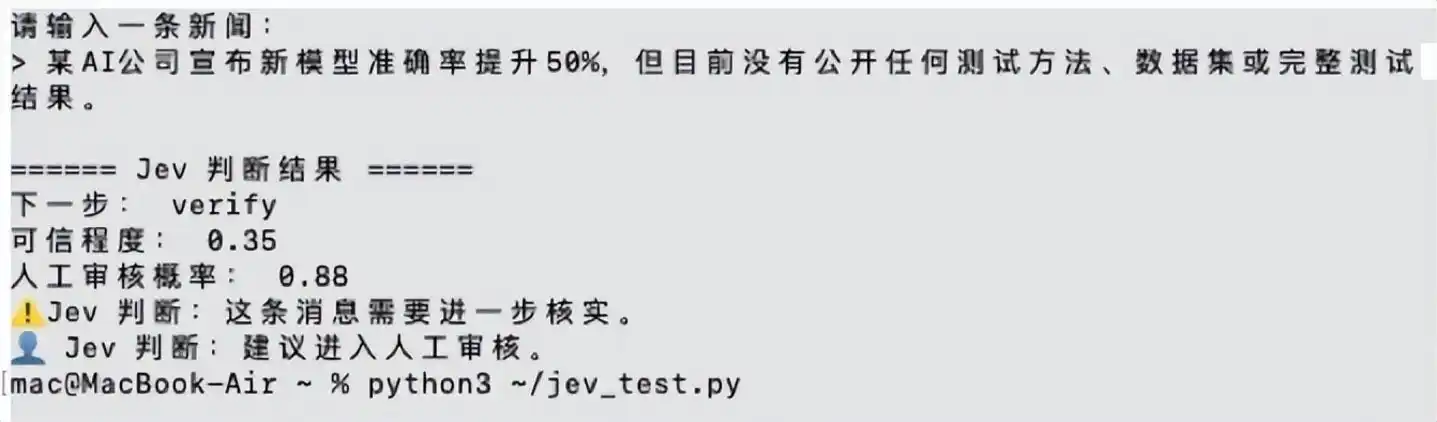
第一条测试,我们给Jev一条这样的新闻:
“某AI公司宣布新模型准确率提升50%,但目前没有公开任何测试方法、数据集或完整测试结果。”
我们提前告诉Jev,接下来只有三个选择:publish(发布)、verify(核实)、reject(拒绝)。同时,再让它判断这条消息的可信程度,以及是否需要人工审核。
这里还是用到了前面的三种能力。Choice这次负责选择下一步怎么处理,Score负责打分,Noul负责判断是否需要人工审核。后两项的数值,需要结合程序里设置的评分标准和审核条件来使用。
结果是:下一步:verify;可信程度:0.35;人工审核概率:0.88。
也就是说,Jev认为这条消息暂时不能直接发布,应该先核实,而且很可能需要人工看一下。Python程序拿到这个结果后,就可以自动把它放进“待核实”队列,并加上“需要人工审核”的标记。
整个过程其实可以简单理解成:
新闻进来 → Jev判断 → 程序看结果 → 自动执行下一步
不过,我们还想试一个更接近真实使用场景的玩法。
平时用AI查消息,我们经常会碰到一个问题。它能给出一段像模像样的回答,但这段回答究竟有多少依据,能不能直接拿来用,还得自己判断。
所以这次,我们让普通AI先回答问题,再把它的回答交给Jev检查。看看能不能让程序先进行筛选,把需要核实的回答留下来。
于是,我们先对着AI输入了一个问题:
“OpenAI最新模型的代码能力比上一代提升了30% 吗?”
这时就可以同时得到了普通AI的回答和Jev的结果:
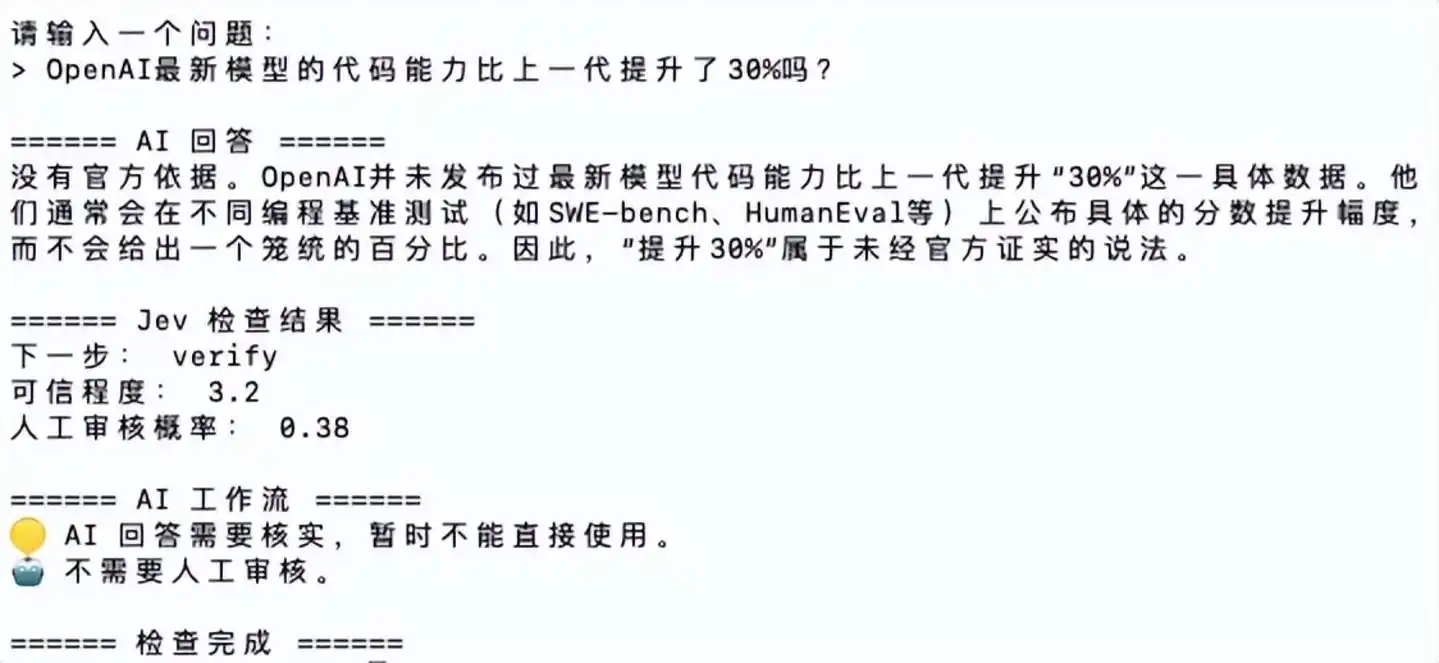
可以见到,基于AI的回答,Jev给出的判断是,下一步是“verify”,可信程度3.2,人工审核概率0.38。
根据前面的三个选项,publish表示可以采用,verify表示需要核实,reject表示拒绝采用,也就是说AI回答的这个答案还是有点问题的。
当然Jev给出verify,也不等于它认定AI的回答是错的。
而人工审核概率为0.38,也没有达到我们设置的人工审核条件,所以程序没有把它交给人工,而是让它继续进入自动核实流程。
这样一来,一个最简单的“AI + Jev”的组合就形成了一基础流程:用户提问 → AI回答 → Jev检查 → 程序执行下一步
这时就可以让这个流程进入一个更加具体到场景了:
还是让Jev判断一条AI新闻应该怎么处理,不过这一次,我们把结果明确分成三个:publish:直接发布;verify:先核实;reject:直接拦截。
然后用Python写一个非常简单的规则:Jev返回什么,程序就执行对应的动作。
第一条测试内容是:某公司已经公开完整测试数据和技术报告,证明新模型性能有明确提升。Jev的判断是publish,直接发布;
第二条换成:某公司宣布新模型性能提升30%,但关键测试数据还没有公开。这一次,Jev给出的结果是verify,待核实;
最后,我们故意把条件变得更加夸张:某公司声称新模型性能提升1000%,但没有任何测试数据,也没有可靠来源。Jev返回reject,拒绝。
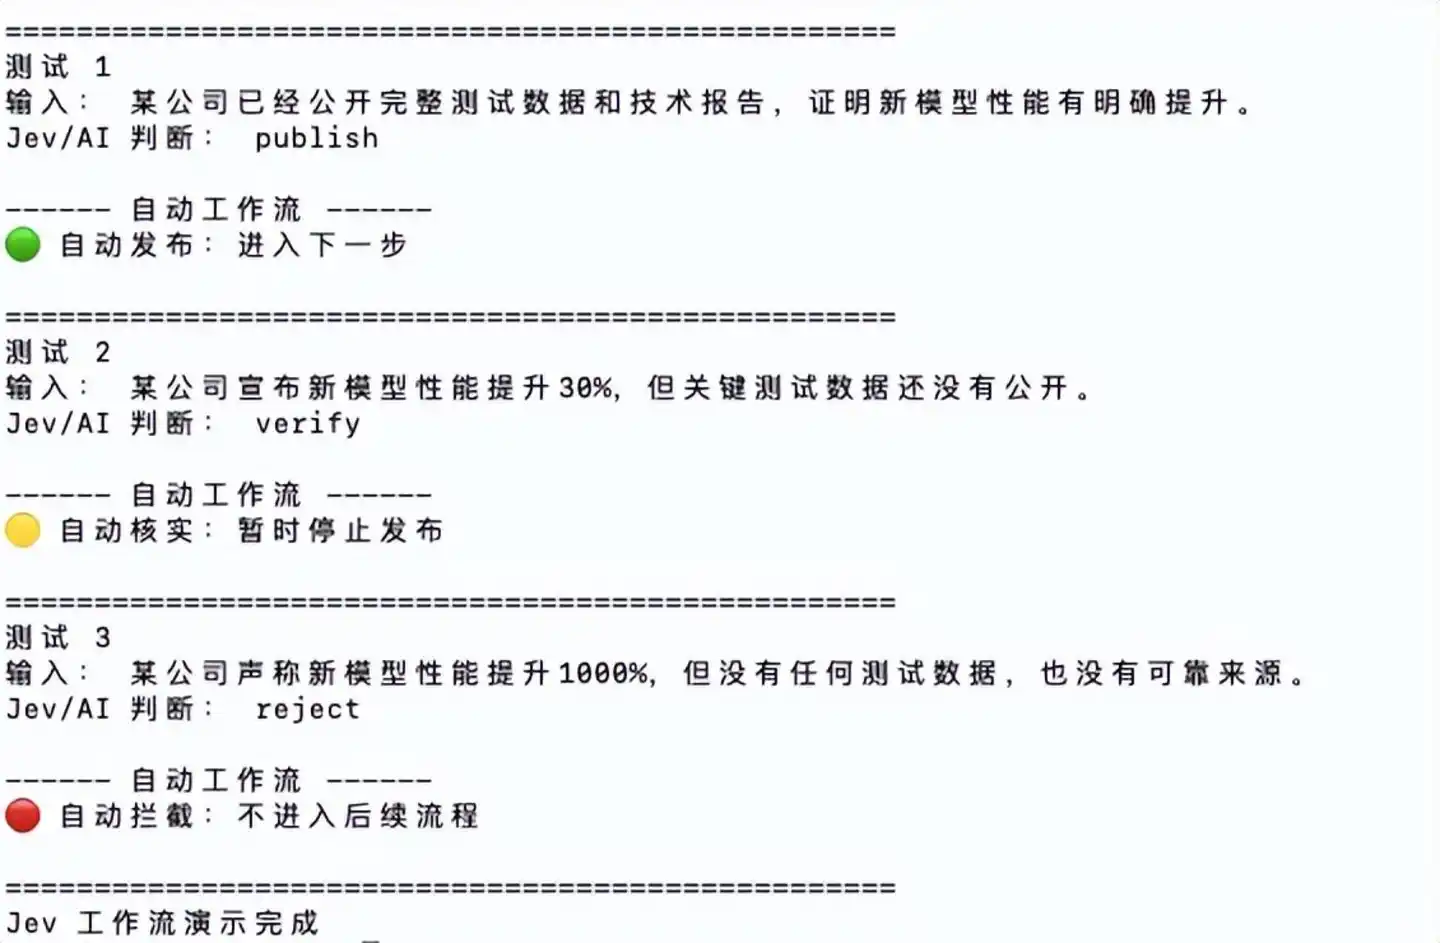
这三轮测试下来,发布、核实、拦截三个分支就都跑通了。
以后再有新闻进来,程序就可以先让Jev判断,再把消息交给对应的步骤处理,省去我们逐条查看结果、手动分类的过程。
下一个Manus时刻?
这次用下来,我们觉得最需要花心思的地方,其实是把问题问清楚。比如“这条消息可信吗”和“这家公司有没有证明性能提升”,看起来差不多,但对AI来说完全是两种不同的判断。
以前我们费尽心力给AI写更好的提示词,现在看来要用Jev这类软件,过硬的语文功底还是必不可少的。先想好自己需要什么结果,才能让Jev帮上忙。
另外,Jev的玩法其实还有很多。前面的新闻审核只是最基础的玩法,已经有人直接拿Jev研究微信聊天。
比如“Crush好感监控器”,就能分析聊天记录里的情绪和意图,还能给自己的回复评级。以前要截图问朋友“他这句话是什么意思”,现在有人把这件事做成了工具。
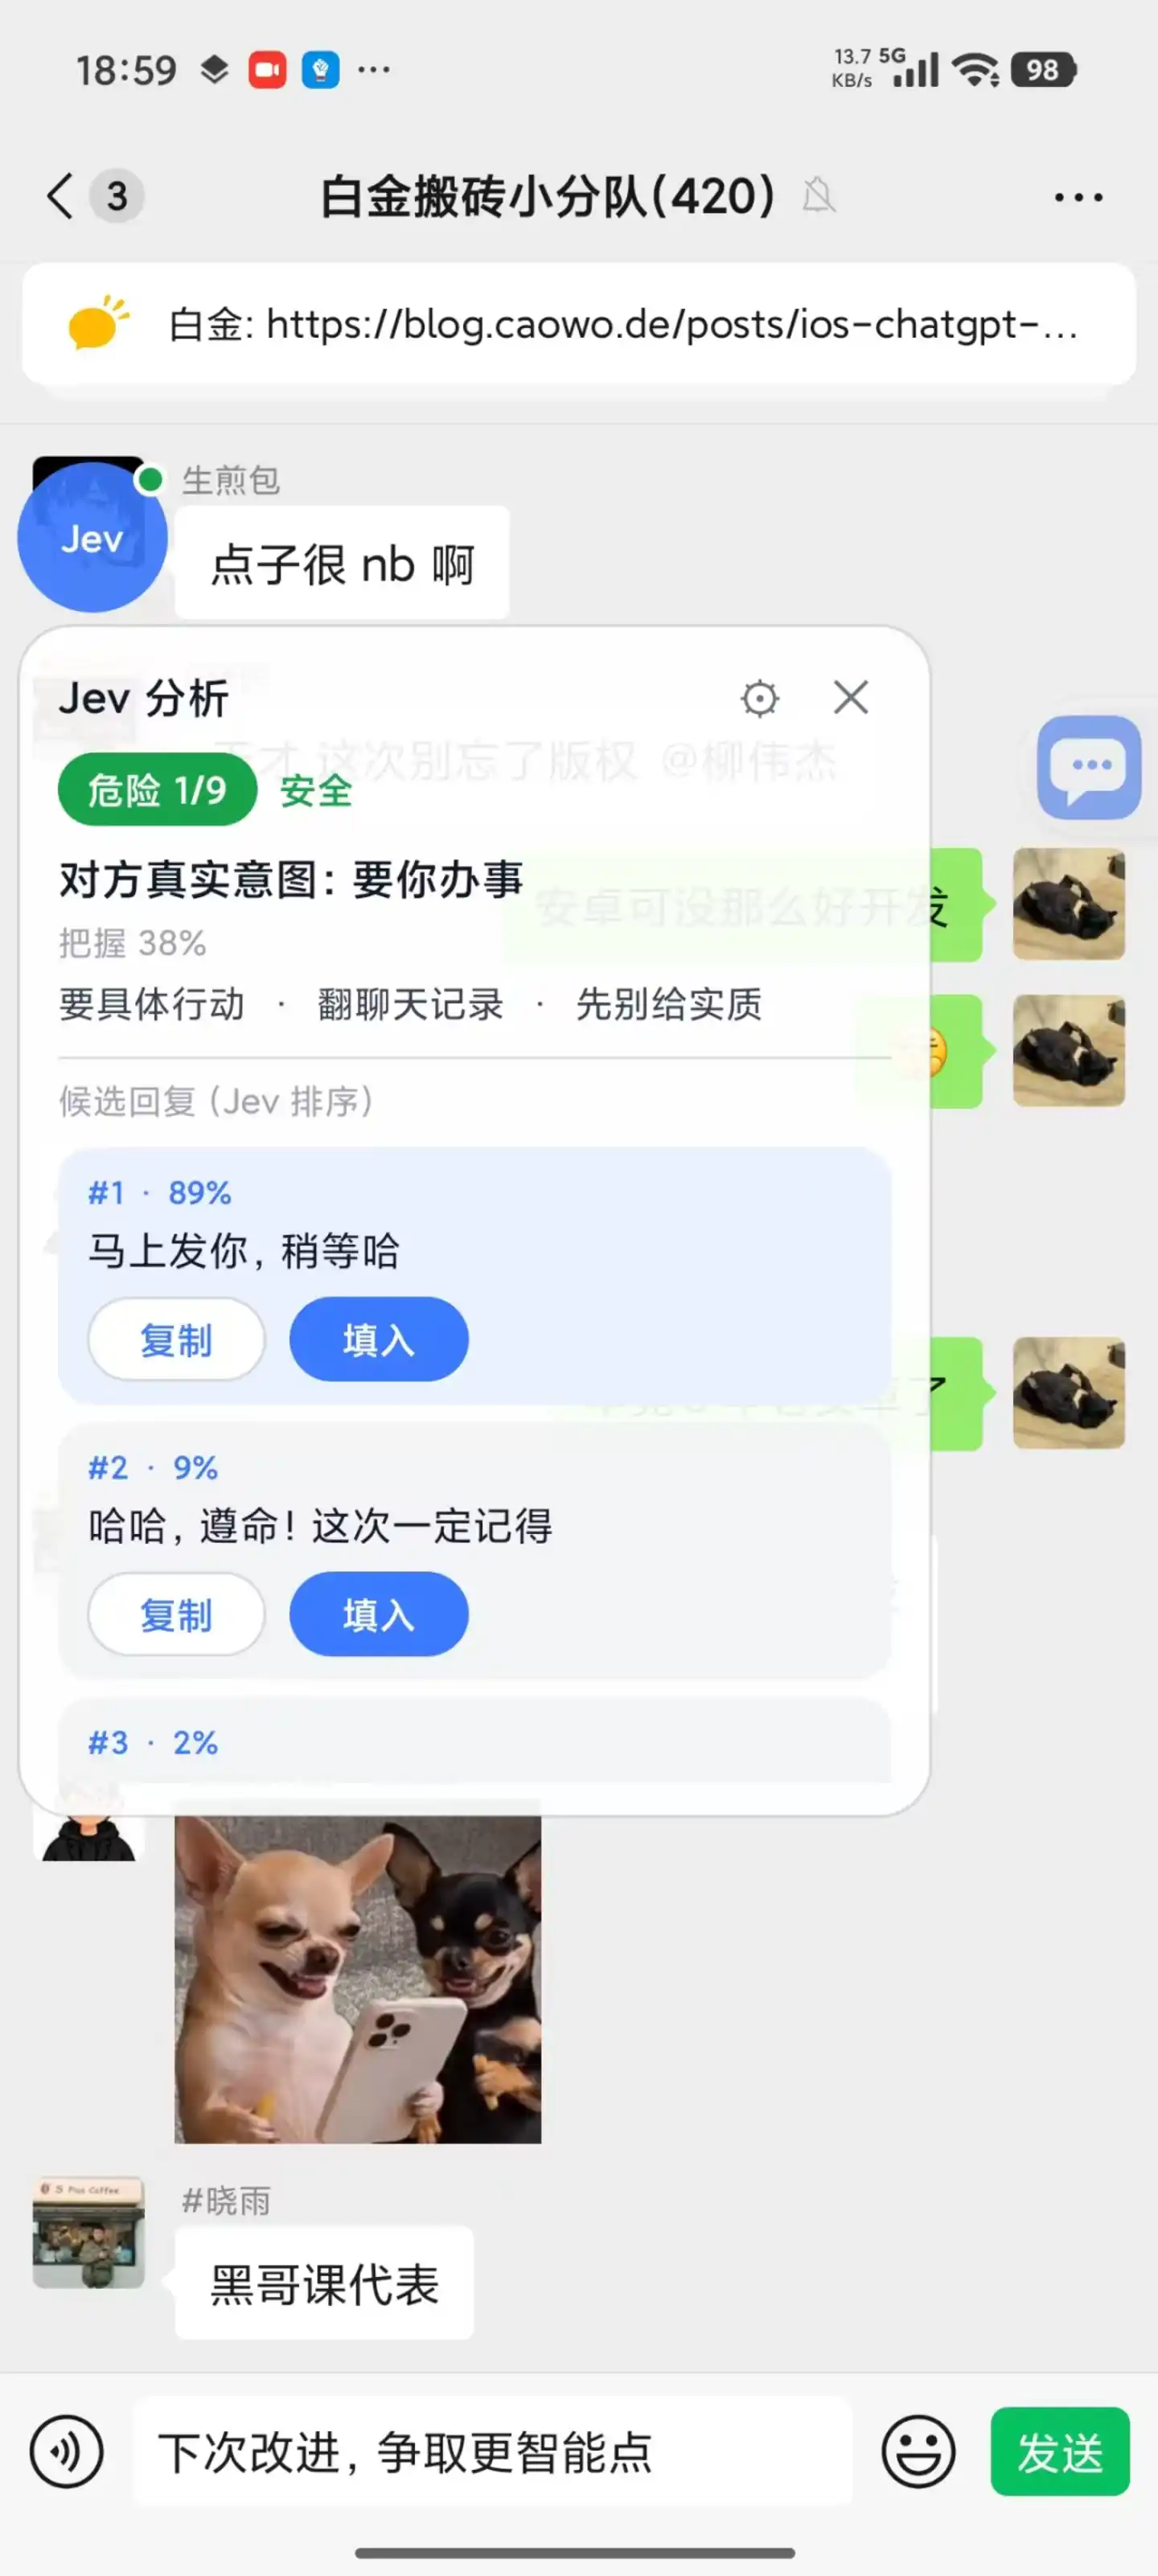
说起来,Jev的热度的确高得吓人,有当时Manus爆火时的味道了。
如果把“Manus时刻”理解成一种让人看完演示,就忍不住想亲手试试的兴奋感,那么Jev身上,或许的确是迎来了属于它但“Jev时刻”吧。
为你推荐
商务合作:TG:@Lottie96
Copyright 火星财经 All Rights Reserved.