


数采中心:机器人的驾校,还是资本的围城
文章聚焦中国具身智能领域爆发式增长的数采中心现象,揭示其在解决物理世界交互数据极度短缺(95%缺口)的同时,暴露出地方政府与机器人企业合建中心、通过关联交易循环融资推高估值的乱象;监管趋严、股价暴跌、IPO收紧反映市场对真实需求和商业可持续性的质疑,核心矛盾在于数采中心是推动产业突破的基础设施,还是资本与政绩驱动的账面游戏。
 摘要由 Mars AI 生成
不到两年,中国冒出了至少90座具身智能数据采集中心。
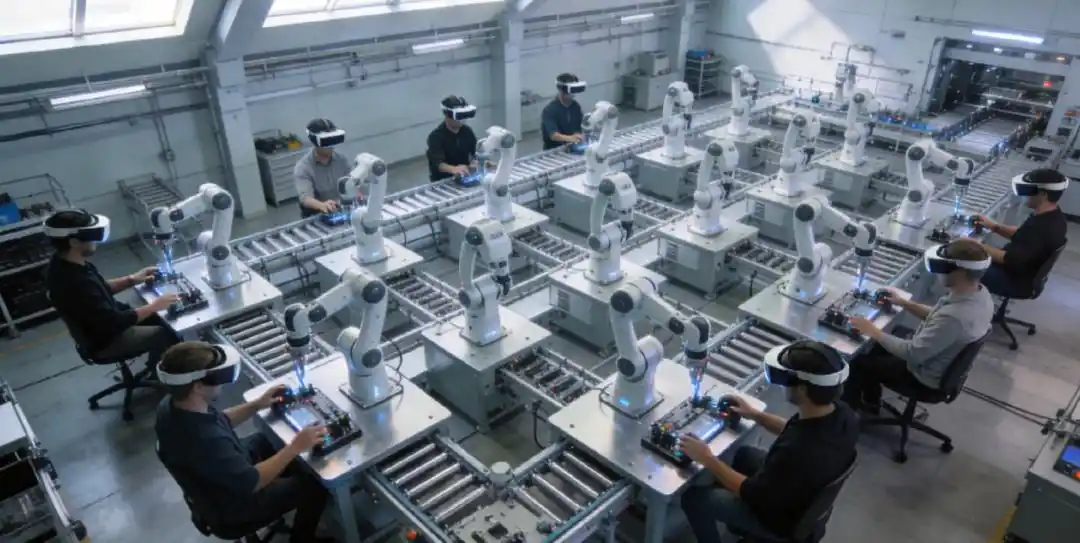
北京石景山一座,占地一万平方米,120台机器人,累计产出117万条操作数据;天津帕西尼一座,1.2万平方米,号称年产2亿条高质量训练数据,还在宿迁、武汉、自贡、赣州各新建一座;智元在上海浦东部署了100多台;京东也入局,号称要建"全球最大",发动60万人采集,两年目标1000万小时数据。
雨后春笋的数采中心,地方政府是主力推手。
从一线到三四线,从沿海到内陆,数采中心成了产业园招商的新标配、未来产业的新名片。卖地收入下滑之后,用数据资产的叙事吸引机器人企业落地,成了不少地方的新思路。
但繁荣之下,质疑在2026年下半年集中爆发。
8月,《金融时报》发表《谁在买中国机器人》,给这套模式贴了一个极具杀伤力的标签——循环融资,就是说机器人企业把机器卖给地方政府建的数采中心,再以采购数据的名义把钱流回去,账面收入做上去了,估值做高了,可数据的真实买家,还是企业自己。
9月,梅卡曼德创始人邵天兰连发两条朋友圈,直指行业内“攒局型”企业靠数采中心和关联交易制造虚假收入,并直接点名估值超200亿元、正在冲刺IPO的银河通用。
监管层的态度也在收紧。据The Information报道,证监会已向部分投行和投资机构发出窗口指导:拟上市的人形机器人企业,得证明自己有持续性收入、在走向减亏,或者有真正的技术创新,IPO申请才可能被纳入考量。
资本市场更早给出了反应。人形机器人第一股"宇树科技,8月19日上市首日冲到1100元/股、市值4449亿,一个月后跌到500元以下,市值蒸发超过2400亿,几乎腰斩。
争议的核心,绕不开“数采中心”这四个字。
它到底是具身智能突破数据瓶颈的关键基础设施,还是企业做高估值、地方完成招商指标的资本游戏?是中国硬科技产业政策的又一次创新实践,还是换了包装的循环采购?
95%的供给差
先来聊聊,具身智能为什么需要数采中心。
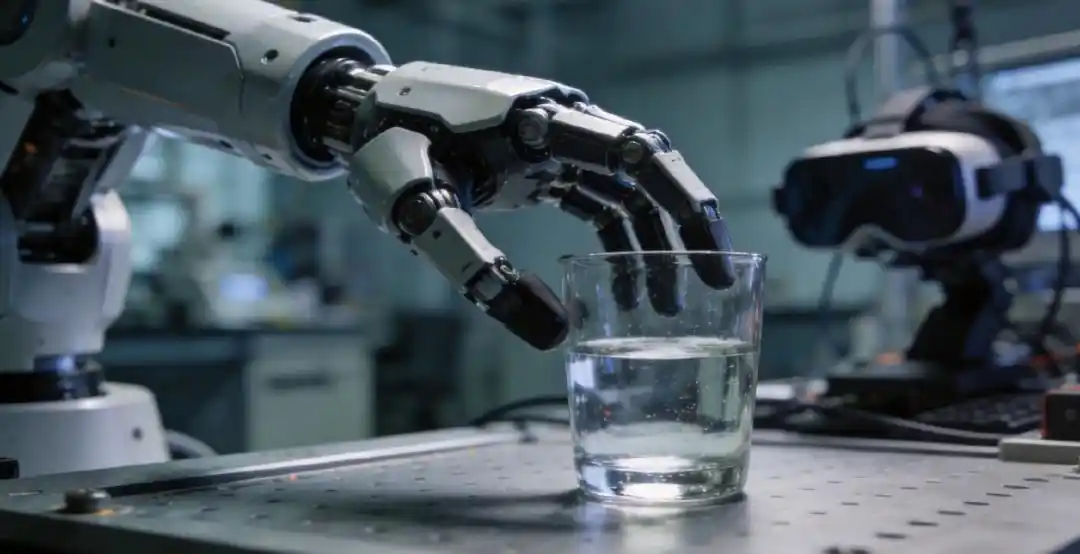
答案是缺数据,而且是极度缺数据,大模型吃的是数字世界的信息,机器人需要的是物理世界的交互数据。
比如你跟大语言模型说“递一杯水”,它能完美理解,但让人形机器人真的去拿一杯水,大概率会翻车。杯子的摩擦力是多少、夹爪用多大的力才不会碎、走路保持什么加速度水才不会洒,这些物理世界的细节,互联网上没有。
石景山训练中心总经理朱凯,把这个痛点概括为六个字: 能对话、难实操。
据《具身智能数据行业研究白皮书》,具身数据有一个金字塔结构:最底层是互联网视频和合成数据,量大、便宜,但精度最低,中间层是动作捕捉数据,人穿着动捕服做动作,机器人跟着学,精度提升了但隔着一层,最顶端是遥操作数据,人直接操控机器人做,力觉、触觉、视觉、关节角度全同步,精度最高,但也最贵。
数采中心干的,就是金字塔顶端这层活。
贵到什么程度?帕西尼的人算过账:一台机器人本体造价60万到70万元,采集人员需要有产业经验的专业团队,大型场地一万平米起步,再加几百PB的存储和算力,算下来,一座标准数采工厂的投入绝对不是小数目。
更关键的是规模缺口。国金证券测算,要训练出具备实际应用能力的具身智能模型,至少需要1000万小时的多模态交互数据。而全球当前积累的数据量,不到需求的5%。
5%的供给,意味着95%的缺口。
这个缺口之所以这么难补,是因为光堆设备远远不够。一套采集设备,加上采集人员工资,按全球平均水平,光人工成本就已经足够高, 再乘以一千万小时,这个投入规模不是多建几个数采中心、增加几个工位就能堆出来的。
数据也不是越多越好,早期需要广度,但后期需要深度,比如面向中国家庭的机器人就得熟悉中国家庭的空间、物品和习惯,越接近商业场景的数据,越难拿,也越贵。
这就是整个行业的基本盘,数据极度稀缺,谁能先攒出足够的数据,谁就可能在模型能力上拉开差距。也正因为稀缺,围绕数据的生意才变得格外热闹,也格外复杂。
数采中心的全国竞速
2025年之前,“数采中心”还是个业内小众概念。转折点出现在2025年下半年,此后便一发不可收拾。
2026年3月是一个集中爆发的月份,智元与成都郫都区共建的西南具身智能产业基地开启试装配;乐聚与济南平阴县共建的人形机器人数据训练中心上线;北京石景山训练中心启动三期;帕西尼宣布在宿迁、武汉、自贡、赣州再建四座工厂,搞“全国分布式采集矩阵”。
据Interact Analysis统计,截至2026年4月底,全国已有至少90座人形机器人数据采集和训练中心投入使用或在建,其中64座已运营。规模较大的就有15座,郑州、无锡、济南、绵阳等二三线城市也在跟进,占地面积多在3000到5000平方米,部分达上万平方米。
地方政府为什么这么积极?
在政策层面,2026年具身智能第二次被写入政府工作报告,列为未来产业重点方向。调子定了,下面自然要跟进。
更实际的动力是招商,一家头部机器人企业落地,上游能带动零部件供应商,下游能带动应用场景开发,中间还能吸引一批高端人才。对正在寻找新经济增长点、尤其是卖地收入下滑的地方政府来说,数采中心是一个完美的抓手——投资、就业、产业链、科技名片,一个都不少。
而且以前靠低价出让工业用地吸引制造业,赚的是土地出让金和税收。现在靠出资建数采中心吸引机器人企业,地还是那块地,建筑从厂房变成了训练场,有人管这个叫“数据财政”。
但“数据财政”能不能成立,取决于一个核心问题:采集出来的数据,到底值不值钱?
如果数据有市场、有人买、能反哺模型、能产生真实价值,那数采中心就是数据矿山。但如果数据的唯一买家就是制造这些数据的机器人企业自己。那“数据财政”就不是收入,而是换了包装的支出。
2026年8月,FT的报道把“循环融资”这个标签贴到了中国具身智能行业身上。
这个词最早是用来形容英伟达的,英伟达投资AI初创公司,初创公司拿了钱买英伟达GPU,资金绕一圈又回去了,营收和估值同时膨胀。
但中国的版本分量更重,因为英伟达的循环发生在企业和私人资本之间,是商业行为,而中国的循环涉及地方政府和公共资金。
至于这套循环怎么转?可以一起熟悉下。
第一步,建中心。 机器人企业与地方政府谈合作,双方成立合资公司,政府通过国资平台出主要资金,企业出技术和品牌。
第二步,卖机器人。 合资的数采中心向机器人企业采购几十台上百台设备,单台60万到70万元。一个二线城市的数采中心,单次采购金额通常在大几千万到上亿元,企业的账面上多了一笔营收。
第三步,买数据。 中心运行起来后,企业以“采购数据服务”的名义向中心付费,钱又流了回去。
转一圈下来,政府出的钱变成了中心的资产和运营成本,企业报表上多了一笔营收和一笔数据采购成本。但数据的最终消费者是谁?是机器人企业自己。
FT采访的训练中心工作人员坦言:只有一小部分数据被卖给了机器人制造商以外的买家。
独立科技分析师赵赛坡的概括很精准:“独立需求与一个政策支持的生态系统内部创造出来的需求之间的区别因此变得模糊。”翻译过来就是,当买家是在同一个体系里被造出来的时候,需求这个词就没有意义了。
数采中心的两面性
说到这儿,容易产生一个误解,数采中心就是骗局。
事实没这么简单,数采中心本身是有真实价值的。
行业确实缺数据,机器人确实需要练习,地方政府想发展未来产业也没毛病。数据是具身智能的核心生产要素——这不只是企业说的,国家发改委也明确说了,要搭建真机数据采集体系,破解“数据饥渴”。
正常的数采中心应该是一个正向闭环:机器人进入真实场景 → 产生有效数据 → 数据进入模型训练 → 能力提升 → 回到场景完成更多任务 → 客户愿意持续付费 → 新的订单和更多数据。
每一环都在创造价值。
有没有这样的正面案例?有。
比如它石智航和安波福的合作,研发团队到车间一线,连续数月磨合工艺细节,机器人从单个工位拓展到整条产线,百台机器人集群稳定作业,正向千台级规模化部署迈进。
上海新智具身走的是触觉路线,脱胎于复旦大学,自建了千平米触觉数采工厂,采集精细操作的全维度物理信息,视触觉传感器也进到头部客户体系验证。
这些公司也有数采、也和政府合作、也拿融资,但区别在于,数据真的进了模型,模型提升真的带来了订单,订单真的来自终端用户,用户真的愿意持续付钱。
那变质的数采中心是什么样的?机器人采购了、中心建了、基金投了,但机器人大部分时间在吃灰,数据采了但没真正进入训练,客户只有政府和关联方,没有复购、没有终端需求。钱在体系里转来转去,账面好看了,估值上去了,机器人还是不会干活。
两者在财报上未必能一眼区分,但有三个硬指标可以当照妖镜。
首先就是脱水复购率,剔掉资方背景客户、关联采购客户后,真正市场化的终端客户,在试点后愿不愿意继续买、持续买?
再有就是数据的真实去向。 采集的数据有没有真的进入模型训练?模型能力有没有可验证的提升?还是数据只是存在硬盘里用来讲故事?
最后,经营性现金流,卖一台亏一台、靠融资输血维持的增长,不是真增长。
所以数采中心没有原罪,它可以是产业加速器,也可以是资本跑步机,关键不在形式,而在内容。
新能源的老路走不走得通
支持数采中心模式的人,最爱拿新能源汽车和光伏说事。
逻辑很顺,当年新能源也是靠政府补贴起来的,光伏也是靠政策扶持做到全球第一的。政府先托住初始需求,等产业成熟了,真实需求自然接上。这是中国的拿手好戏。
这个类比听起来有道理,但有一个关键区别。
新能源汽车的补贴,是补给真实存在的买家的,公交公司本来就需要公交车,出租车司机本来就需要出租车,消费者本来就想买车。补贴降低了购买成本,但没有改变“他们需要这个产品”这个事实。
数采中心模式不一样。它不是在补贴买家,它是在创造一个本来不存在的买家。如果没有政府牵头建的数采中心,这些机器人能卖给谁?真实的工业客户、商业客户,愿意以现在的价格和数量采购吗?
补贴买家,是帮产业跨过初始成本门槛。创造买家,是帮产业绕过市场验证环节。这是本质区别。
另一个参照物是美国DARPA模式,国防部出钱搞挑战赛,高校和企业出方案,能不能产业化各凭本事。但DARPA的资助是研发投入,不是营业收入。没人把DARPA的奖金计入营收。
数采中心模式的微妙之处就在于,它把研发投入包装成了营业收入。研发本该记在成本端,结果摇身一变成了收入端的亮点。报表好看了,估值更高了,融资更容易了,但技术进步了多少,数据积累了多少,只有天知道。
互联网泡沫破裂时,被淘汰的是没有收入的公司,活下来的是有真实用户的产品。而中国具身智能行业的问题可能更棘手,它可能连真实用户都还没找到。
当然,硬科技产业化需要耐心,需要政府、资本、企业的长期投入。但耐心投入和账面游戏是两回事。耐心投入是真砸钱搞研发搞数据搞场景,虽然慢但每一步都算数。账面游戏是靠关联交易把收入做漂亮、把估值吹上去、把IPO排上队,技术什么时候能落地——先上市再说。
后一种模式,我们见过太多次了。
谁在买单?
如果数采中心的某些模式确实有问题,谁在为虚火买单?
至少有三层。
第一层:地方政府。
用有限的财政空间建数采中心、采购机器人,换来的是政绩、招商指标、产业落地的叙事,以及“数据资产”的账面增值。这笔账划不划算,取决于数据是否真的有价值、产业是否真的能起来。
至少从目前的证据看,数据的市场化需求非常有限。如果数据卖不出去,“数据财政”就不是收入,而是换了包装的支出。
第二层:二级市场投资者。
宇树科技的股价走势已经给出了部分答案。
原因不难发现,发行市盈率219倍,行业平均才38倍多。上市首日流通盘只有7.4%,供需极度失衡,资金把预期一次性打满,动态市盈率干到800多倍。
这不是定价,这是许愿。
报表给狂热浇了冷水。2026年一季度,宇树营收增速从去年的332%回落到68%,扣非净利润同比下滑52.55%。上半年扣非净利润预计下降6%到22%。
一个投资者在上市当天以925元买入400股,一个月后浮亏接近18万。这些追高的散户,是第二层买单者。
第三层:真正相信中国机器人有真实生产力的人。
他们可能是工业客户,可能是普通股民,他们相信具身智能能改变生产力、能提升国家竞争力、能创造真实价值。
当制造买家比制造产品更容易获得回报时,当会计操作比技术研发更快推高估值时,当讲故事比造好产品更能拿到融资时,最后为这一切买单的,就是这些真正相信产业价值的人。
这才是最让人担心的。具身智能是国家战略必争之地。全球都在抢制高点,美国Figure AI拿到了数十亿美元支持,特斯拉计划投入200亿美元。中国有完备的制造体系和海量应用场景,这是优势,不能丢。
但如果大量资源被消耗在循环采购、估值炒作、账面游戏上,真正用于研发、数据积累、场景落地的资源反而被稀释了,那最后受伤的不只是投资者,更是整个国家在这个赛道的竞争力。
这也是为什么发改委连续发声“防止盲目跟风、一哄而上”,为什么证监会在收紧IPO门槛,为什么新华财经呼吁建立“可核验的作业能力评价体系”,把竞争拉回到模型能力、数据沉淀和工程落地上来。
行业不能再比拼样机,也不能再比拼谁的故事讲得好了。
等待时间验证
2026年的秋天,具身智能行业站在一个微妙的十字路口。
一边是近千亿融资、上百家企业、90座数采中心、万余台出货量的繁荣图景。另一边是循环融资的标签、同行的炮轰、股价的腰斩、IPO的收紧。
数采中心就是这个十字路口最显眼的路标。
它可以是机器人的驾校,让机器人在上岗前系统学习技能,为具身智能的ChatGPT时刻攒够燃料。它也可以是资本的围城,企业、政府、投资方在城墙里玩着资金循环的游戏。
它可以是产业政策的创新实践,用政府耐心资本撬动硬科技早期发展。它也可以是换了包装的旧玩法,从土地财政到数据财政,从招商引资到概念招商。
真相大概率是两者的混合。有些中心在真干活、真产数据、真推模型。有些在做表演、做大账、讲故事。鱼龙混杂,才是真实的产业生态。
但行业不可能永远这样浑浑噩噩走下去。
新能源和光伏的经验是,政府推动的产业政策可以成功,但补贴退坡后,真实需求必须能接上来。数采中心模式能不能通过这个检验?现在还没有答案。
具身智能的“ChatGPT时刻”终究会来。但在那之前,这个行业需要先穿越一片迷雾。迷雾里有真金,也有泡沫;有开路者,也有搭车人;有宏大叙事,也有精致的会计结构。
穿越迷雾的唯一方式,不是比谁的故事更动听,而是比谁的机器人更能干。
潮水退去的时候,谁在裸泳,一目了然
本文来自微信公众号“超电机器人”,作者:在洲
为你推荐
商务合作:TG:@Lottie96
Copyright 火星财经 All Rights Reserved.