


AI推理大爆发,“悲催”闪迪真有凤凰涅槃?
AI推理需求爆发推动企业级SSD尤其是QLC和PCIe 5.0/6.0 SSD需求激增,NAND闪存从周期性大宗商品转为战略资源。闪迪完成与西部数据分拆,专注NAND与数据中心SSD,依托与铠侠的长期合资产能、CBA键合架构及HBF高带宽闪存技术,在位密度和AI适配性上处于行业领先,充分受益于AI基建带来的存储需求升级和周期上行。
 摘要由 Mars AI 生成
本轮AI浪潮让NAND闪存从“周期性过剩的大宗商品”变成了“供不应求的战略资源”,闪迪在分拆、甩掉了传统硬盘业务的拖累后,纯粹押注在NAND和数据中心SSD上,正好踩中了这个风口。
AI服务器在进行推理、处理复杂的Tokens、Prompt、多模态输入(视频、图像)以及生成合成数据时,需要高频、反复地读写历史数据。传统云架构的存储配置已经无法满足需求,现在的AI服务器单节点对NAND闪存的消耗量呈指数级增长。
在训练为主导的阶段,各家厂商更多重心在比拼算力方面;而进入推理阶段时,“AI基础设施=XPU+存储+连接”,算力重要性削弱的同时,更注重存储和连接领域的需求。
AI基建是如何影响NAND整体行业需求的呢?实际上AI数据中心并不是需要全部的NAND产品,主要需求集中在企业级SSD上。在当前Agentic AI及大推理时代,AI最需要的是超大容量的企业级QLC SSD和高带宽、低延迟的PCIe 5.0/6.0 SSD。
在下游大型CSP们拿着高溢价和长期订单来抢购企业级SSD的情况下,存储厂商将原本用于生产手机和PC的产能,大比例调整去生产AI企业级产品,“供给端的挤压”间接影响了整体NAND领域的供需格局,带动NAND整体的周期上行。
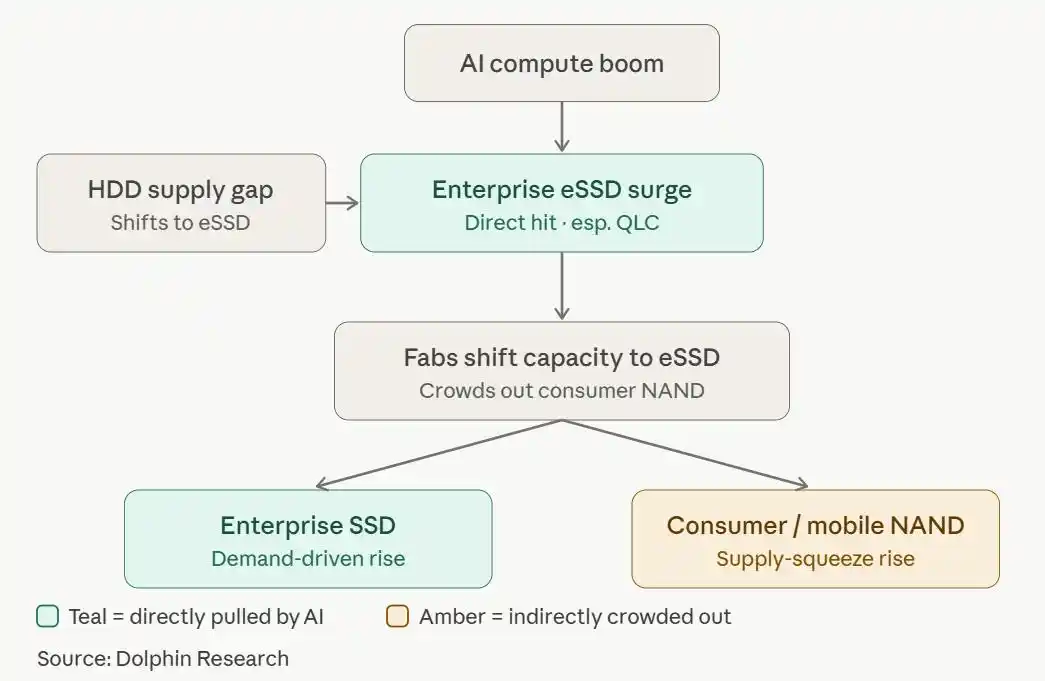
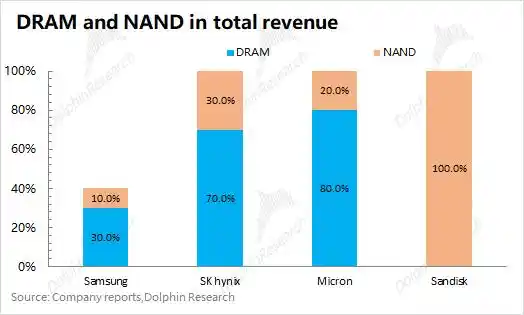
在NAND市场上,主要玩家有三星、海力士、美光、闪迪等,而其中闪迪是最为纯粹的一个。三大原厂的重心仍在DRAM及HBM领域,闪迪在甩掉传统硬盘之后,全部聚焦于NAND闪存市场,将完全受益于本轮NAND的行业面“升温”。
对于闪迪公司,海豚君在本文中主要围绕三个问题展开:①闪迪与西数的关系;②闪迪与铠侠的合作;③闪迪的NAND技术在行业面怎么样。后续闪迪公司的业绩表现及估值定价将放在下篇文章中,欢迎继续关注。
在技术策略上,闪迪不“死磕”层数,主攻“横向微缩”实现行业最高位密度;率先量产CBA键合架构以提升性能能效;并联合首推针对AI推理的HBF(高带宽闪存)技术,综合技术依然在NAND厂商中处于相对领先的第一梯队。
在AI大模型推理引爆超大容量企业级QLC SSD强劲需求的情况下,闪迪凭借与铠侠延长至2034年的稳固产能保障、“纯血NAND”的高业绩弹性和HBF的潜在机会,公司将继续享受AI基建带来的增长红利。
以下为详细分析
一、闪迪与西数:十年之痒,“分开”两利
首先我们来看,闪迪是一家怎么样的公司?闪迪(Sandisk)虽然上市不久,但其实是存储行业中的“老炮”。闪迪创立于1988年,是闪存技术的开创者之一,在2016年被西部数据以160亿美元左右的价格进行并购。
由于HDD和NAND两类产品的成长性及发展逻辑有明显的不同,会让公司整体受到市场性的“低估折价”影响。2023年10月,西部数据宣布计划将其闪存业务分拆至以闪迪公司名义成立的新上市公司,西部数据则专营硬盘业务,并在2025年2月重新实现“单独”上市。
在当时分拆的时候,西部数据保留了闪迪19.9%的股份,至2025年6月已经减持至5%左右。由于西部数据在当时收购闪迪的时候,合计借了180亿美元左右的并购贷款,近十年公司一直承受着“高额债务”的重压。
在闪迪股价持续走高的情况下,西部数据也打算将手中的“闪迪股票”变现,从而减轻公司的债务压力。在2026年2月的公告中提到:西部数据计划将持有的750万股闪迪股票全部处置,这大约能减少30多亿美元的债务。
在750万股的处置中,西部数据一共分了两步走:
①通过“债转股并在二级市场公开发售”的方式处置了582万股。具体流程是“先借了一笔过桥资金->用过桥资金把所有高级票价赎回->债转股->银行转手卖出”;
②用“股换股”的方式处置了剩余的169万股。具体操作是“把闪迪股票换成自己的股票,再把“换来的480万股”注销掉”。
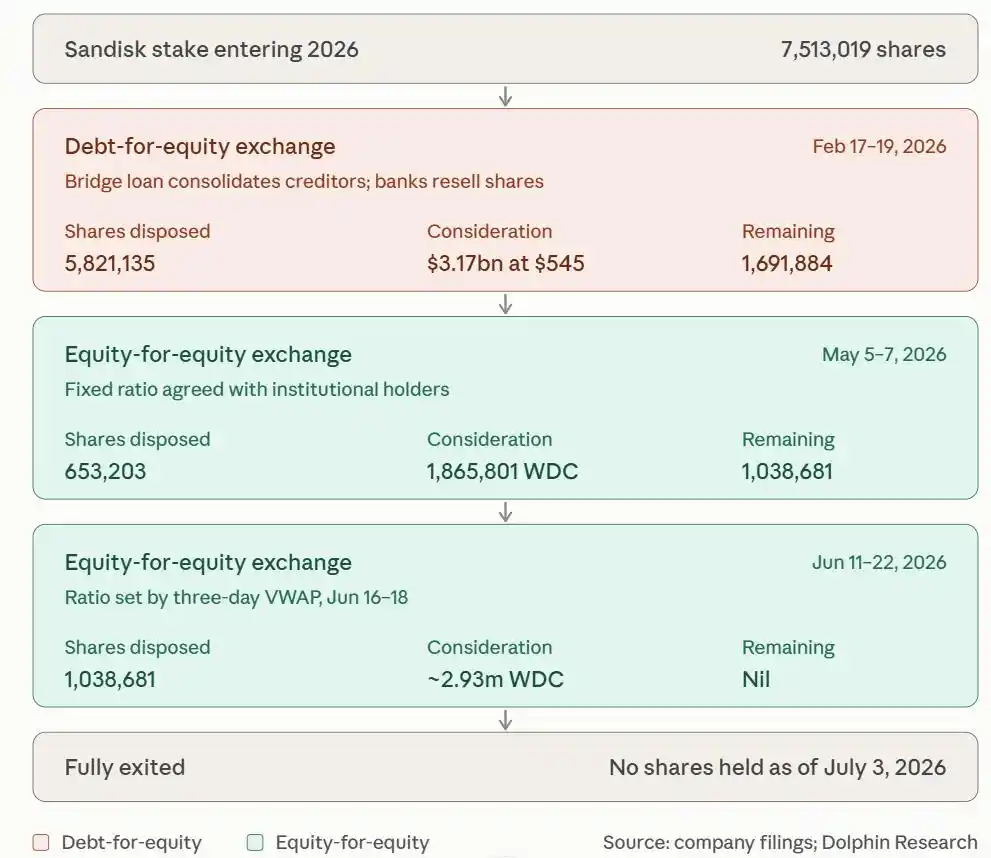
通过以上的操作,西部数据将闪迪进行“分拆剥离”,其实对双方都是有利的:①西部数据在减轻债务压力的同时,更能聚焦在HDD领域;②闪迪成为一家完全独立的NAND闪存和固态硬盘公司。双方在股权上“彻底脱钩”,闪迪拥有独立的主导权,不用再兼顾HDD。
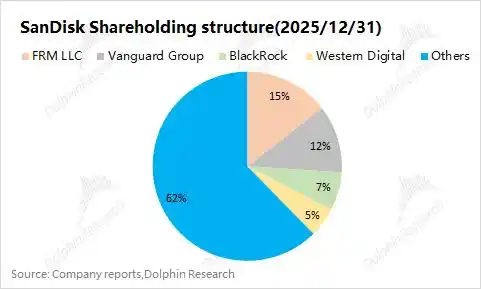
截止至2025年末,西部数据依然是闪迪的大股东之一。而随着西部数据清空闪迪股票之后,闪迪将成为由华尔街机构所控制的独立科技公司,公司大股东主要是富达投资、先锋基金、贝莱德等机构,西数的“抛压”已经消化掉了。
二、闪迪+铠侠:20多年的持续合作
相比于美光等厂商,闪迪的产品更为“单一”,公司收入全部来自于NAND领域。本轮AI浪潮的关注度一开始集中在HBM领域,闪迪在那时候并未受益。而当存储周期开始转向NAND的情况下,“all in NAND”的闪迪表现也是更具弹性的。
从行业面来看,当前NAND行业出货量主要来自于三星、海力士和美光三大原厂,而铠侠(Kioxia)和闪迪紧随着这三家,大致占有15%左右的市场份额。
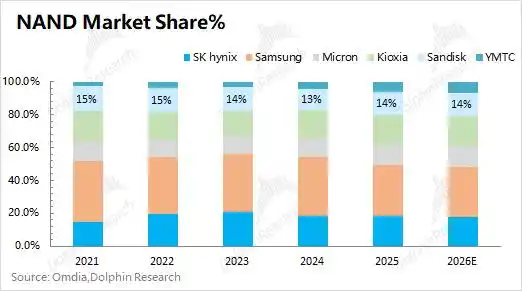
闪迪和铠侠的市场份额长期以来都是比较接近的,而这里需要理解的是,闪迪的产能基本都来源于日本合资工厂,与铠侠平分晶圆产能(大致是4:6的关系)。
虽然东芝(铠侠前身)发明了NAND,但缺乏大规模商用化的资金和系统集成经验;而闪迪则拥有相关技术和市场渠道。因此,双方在2000年左右决定在日本四日市合作建立晶圆厂:
①共同出资:购买半导体制造设备(光刻机等),分担重资产风险;
②研发共享:在同一实验室研发BiCS架构(die之前的环节是共研的),技术成果共享。而在die之后的环节,两家公司是通过自研构成差异化;
③产能分配:平分晶圆产能,各自拿走大约一半左右的晶圆(前道产能),独立销售。
闪迪与铠侠的合作关系是相当稳固的,中间经历了闪迪的收购及独立、东芝存储的更名,而双方的合作协议都并未中断。独立后的闪迪,在2026年1月宣布将原定于2029年到期的合资协议再次延长至2034年12月31日,保障了双方合作的持续性。
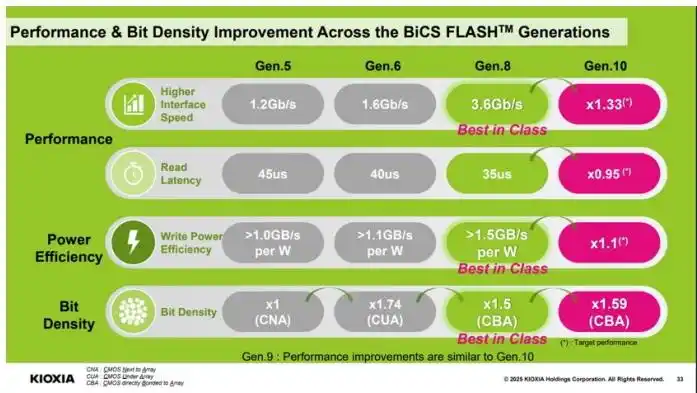
两家公司在同一天宣布2026年7月BiCS10工程样片送样,规格完全一致——332层、1Tb TLC、密度超过29 Gb/mm²,较BiCS8提升59%,接口速度4.8Gb/s(+33%),沿用8 代引入的CBA与OPS技术。
当前闪迪的NAND晶圆基本都来自于日本的两个大型基地:①四日市基地,世界上规模最大的闪存生产基地,拥有Fab3至Fab7等多座工厂;②北上基地,新兴的增量基地,拥有K1和刚刚投入运营的K2工厂。
铠侠在8月27日宣布已启动北上工厂Fab3的场地平整及相关准备工作,厂址在Fab2以南,目标2029财年投产,用于扩产先进BiCS FLASH。
两家公司在同日宣布2032年前(在延长后的合作协议之内)在日本投资超过310亿美元(约5万亿日元),前提是获得政府支持,市场预计K3约占其中1.8万亿日元(约113亿美元)。
三、NAND的堆叠技术能力及经济性
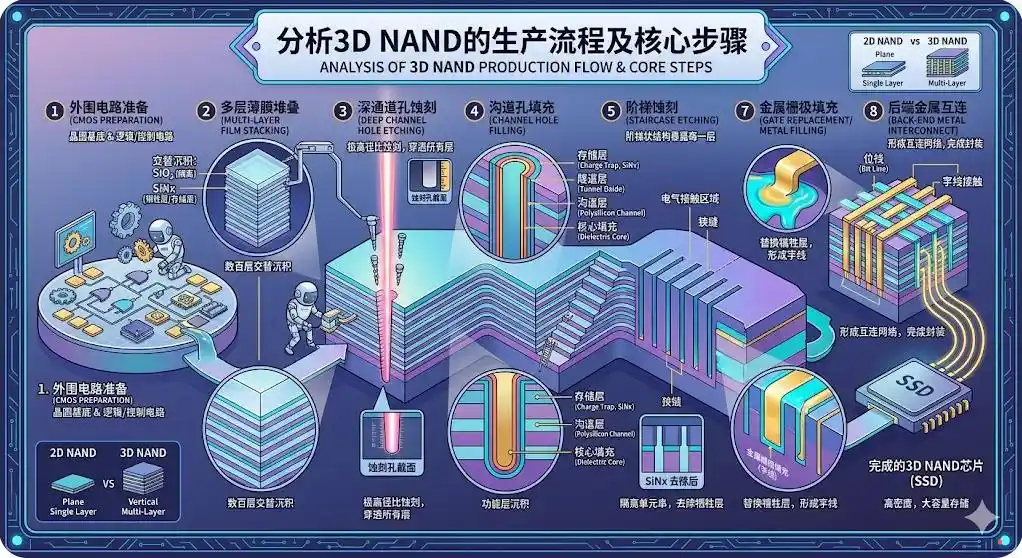
当NAND产品从2D进阶到3D的时候,这已经不单单是制程的比拼,更重要的是层数的叠加。3D NAND的容量提升,不再依赖于制程微缩,而可以通过增加堆叠层数的方式来实现,从而跳出了制程的“死胡同”。
NAND堆叠层数的增加,能直接带来存储密度的提高,这意味着用少量的资本开支也能实现NAND供应量的提升。因而各家厂商的层数进展,也能体现在NAND领域的产品能力。
a)堆叠技术选择
在堆叠层数不断增加的情况下,其中最大的技术难点在于深通道孔蚀刻:具体就是在200-300层膜层中,垂直打出数十亿个直径几十纳米的孔。
当单层刻蚀到200-300层的情况下,基本接近于极限。这就好比用一根细针,精准地刺穿几百张纸,中途不能断、不能歪,并且到底部的孔径还不能变细。
在进入200层级以上时,美光、三星等厂商基本采用双堆栈的方式。具体是,“先沉积100-120层材料,先进行第一次深孔刻蚀;再沉积第二组100-120层材料,进行第二次刻蚀。
在进一步向300层迈进的时候,三星和海力士选择了两种不同的方式:
①三星:计划通过材料的改进,继续用双堆栈的方式来实现更高的层数增加。由于堆栈次数越少,生产步骤也会越少,理论上能实现更高的良率和成本优势。但是三星V9QLC(286层)在此前因设计问题导致量产受阻,在300层以上级别略有落后。
②海力士:考虑到继续采用双堆栈的方式,风险明显增加(即单次刻蚀需要150层以上)。因而海力士率先转向三堆栈的方式(如100+110+111),需要进行三次沉积和三次刻蚀,并且将每段进行通道孔互连(即严丝合缝的对准)。
目前三星V9还在坚持“双堆叠”,海力士及闪迪都转入了“三堆叠”,而三星下一代的V10也已经确认了将转为“三堆叠”的形式。
b)3D NAND层数堆叠的经济性
当堆叠层数从200层级(232层)提升至300层级(321层),这在物理层数增加的同时,也会使单元尺寸在水平方向进一步微缩以及外围电路架构的优化,带动单片晶圆的位密度提升50%左右。
换句话说,如果一家工厂将原有产线从200层级提升至300层级。即使晶圆投入量不变,存储产品的总产能理论上也能增加一半。
由于通过层数增加就能实现产能的提升,因而NAND厂商往往会选择利用现有产线进行升级改造,这相比于新建产线的投资小了很多很多。其中新建厂房和基础设施全部省掉,只是在设备端替换和追加与新节点相关的部分设备(沉积、刻蚀、键合等),估算升级产线的成本将是新建的1/3左右。
另一方面,随着工序增加的情况(单层堆叠->双堆叠->三堆叠),其中需要的化学气相沉积(CVD)、清洗等流程次数也将增多,这也会直接增加单片晶圆的制造成本。
结合市场情况来预估,从200层级提升至300层级,产能有望提升50%左右,成本端的增加30%左右,平摊到单GB存储成本能下降10-20%。从经济性的角度看,各家厂商会优先选择增加层数堆叠的方式来扩产。
四、NAND各家的技术进展及对比
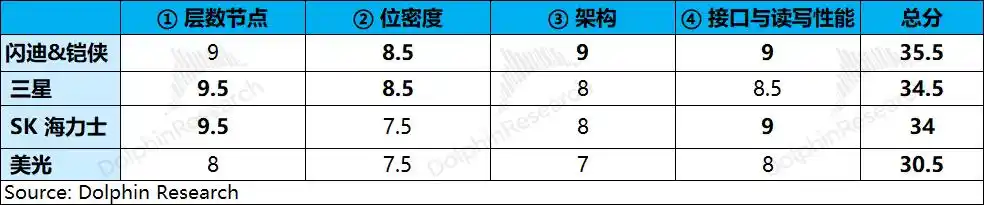
对于各家NAND产品的技术表现如何,其实是有几个维度来比较的,包括层数节点、位密度(Gb/mm²)、架构(CBA键合/单元类型)、接口与读写性能等。
NAND的技术迭代路径,主要也是从层数堆叠、位密度、架构及工艺改进、单位存储数量等方面展开。至于闪迪的选择,并没有去“死磕”层数,而是先将重心主要放在横向缩放、率先引入CBA技术并研发HBF产品方向,尤其是在单层上做多孔的密度,从而实现“单位面积能存更大的容量”。
a)层数节点
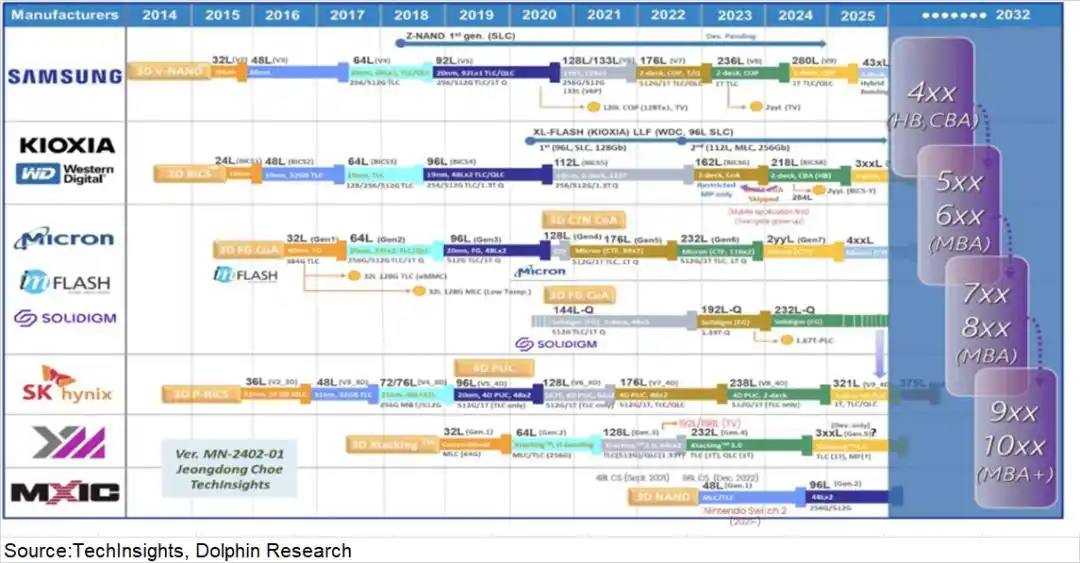
在NAND市场中,海力士在层数堆叠领域是目前最为领先的。海力士公司的321层QLC NAND SSD在2026年4月开始量产交付,是全球首款进入量产交付阶段的300层以上的QLC产品(用了三堆栈的技术)。
其余几家(三星、美光、铠侠与闪迪)在堆叠领域的进展相近,其中按目前主力量产节点来看,321(海力士)> 286(三星)> 276(美光)> 218(闪迪/铠侠)。
①三星:V9 QLC(286层)因为设计瑕疵推迟量产,在经历“返工”后实现量产爬坡。公司把平泽P1原本跑6~8代的旧线改造成V9,同时在平泽P4 PH1和西安扩线,目前V9占比提升至一半以上。
三星公司在2026年8月首发第10代BV-NAND (V10),层数突破400层,公司后来承认将在这个产品中也转向“三堆栈”的方式。
②美光:G9 NAND (276层)是2024年发布的,至今2年过去了依然是公司出货主力。美光当前把重心转移至DRAM领域,NAND进展有点偏慢,市场预计公司的下一代NAND(可能是G10)在2027年下半年才会量产;
③闪迪&铠侠:现在的主力产品是BiCS8 (218层),BiCS10(332层)从2026年7月开始工程送样,下一代BiCS11已进入开发。
闪迪和铠侠由于共用工厂,两家公司是用同一颗die,比如都是基于BiCS8或BiCS10,但两家公司都通过自研控制器和相关固件,实现产品上的差异。
b)位密度(Gb/mm²)
虽然堆叠层数仍相对落后,但闪迪&铠侠的面密度是最高的。这是因为闪迪和铠侠的路线图的核心是,通过“存储孔”密度提升和更紧密的单元封装来增加每片晶圆比特数,而不是简单堆层数——因为层数直接推高建厂资本开支和工艺复杂度。
BiCS架构中具有“横向微缩”的特性。具体来看,就是“把层做薄”和“把孔做密”,从而实现在同样的面积里塞入更多的存储位(即减少公摊面积)。这同样带来的问题是,在做薄的同时,会增加“电荷干扰”和“读写寿命及可靠性”的风险。
基于此,闪迪&铠侠的策略是,“将BiCS9面向于AI PC与手机领域,而BiCS10面向于AI推理与企业级”。其中BiCS9就是在BiCS8的基础上的小迭代,仅仅是微增了层数(218层->230层)。
由于各家产品的精确面密度(Gb/mm²)都未直接披露,结合市场预期,推测各家的面密度大致为:闪迪&铠侠BiCS10(>29)>三星V9/V10(28)>美光G9(21)>海力士Gen9(20)。
c)架构(CBA键合/单元类型)
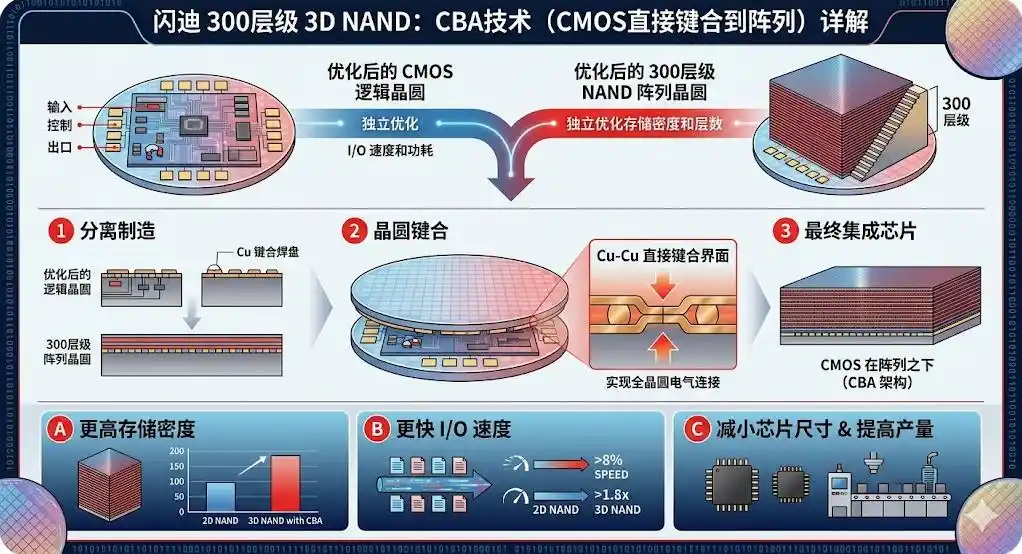
①CBA:在CBA方面闪迪&铠侠是架构维度的先发者,率先在BiCS8(2024年) 中量产CBA(CMOS Bonded to Array)架构——将逻辑晶圆与存储阵列晶圆分开制造、各自最优工艺,再通过Cu-Cu混合键合贴合,实现更高存储密度、更快I/O、更小芯片尺寸。
三星和海力士在2026年才开始使用CBA键合,而美光至今还没使用,预计后续也将在300层+的级别中开始引入。
CBA的方式能实现更高的效率,控制电路(读写速度)不需要受高温的影响,而存储单元在没有电路占空间的情况下,可以叠得更密集,这样也能让层高进一步得以压缩。
②单元类型:QLC(4bit/cell)是企业级大容量主流——闪迪BiCS8配“UltraQLC”2Tb大die;海力士推出321层QLC;闪迪规划TLC(3bit/cell)主打性能、QLC主打容量的产品结构(BiCS9用于1TB TLC die),并明确不会采用PLC(5bit/cell),继续靠CBA+平面微缩提升性能与能效。
TLC、QLC和PLC就是指一个单元(房间里)对应着放置几个电子,虽然从TLC(3个)->QLC(4个)->PLC(5个)的单位存储容量是大幅增加,但由于电子数的增加,也会影响到NAND的使用寿命。
d)接口与读写性能(数据传输速率)
从当前披露的三家厂商的接口速率来看,整体都相对接近。当前主流产品的数据传输速率普遍在3.2-3.6Gbps,而至于下一代产品的数据传输速率有望提升至4.8-5.6Gbps。
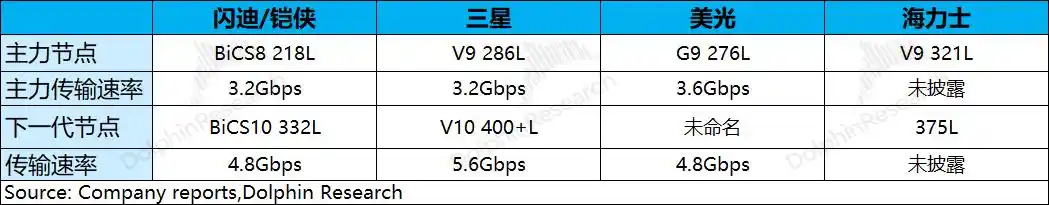
实际上目前的接口阵营分为Toggle DDR和ONFI两类,其中闪迪&铠侠、三星是选用的Toggle DDR,而美光和海力士则是ONFI阵营,速率档位设置略有差异。
三星在V9中依然用了Toggle 5.1 接口,而闪迪/铠侠相对激进,在BiSC9中已经采用了CBA+Toggle DDR6.0,主要针对于高性能客户端与企业级SSD(含AI负载)。
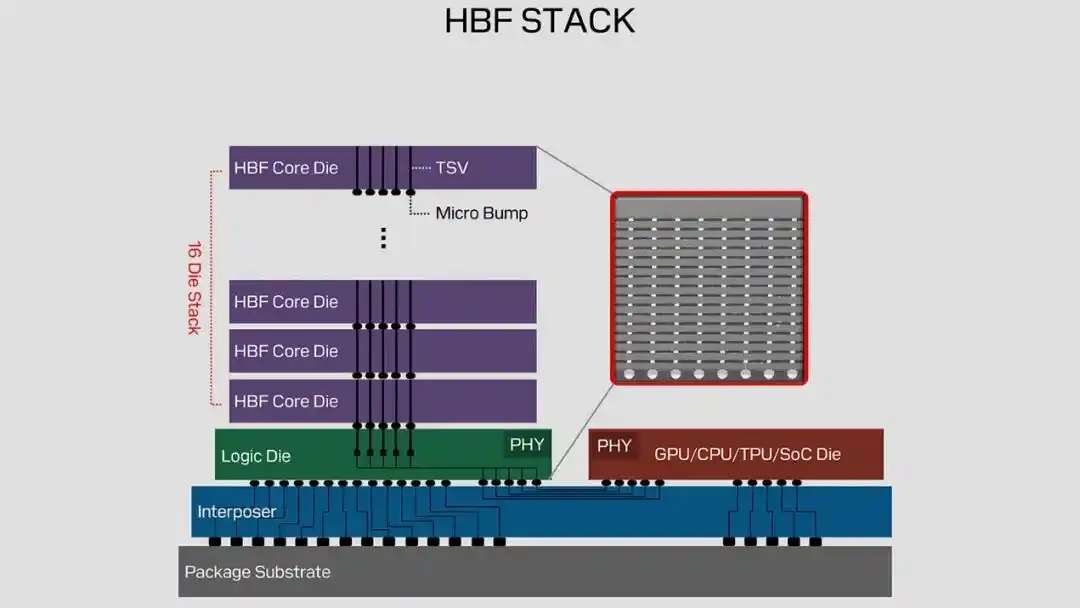
HBF(高带宽闪存)是最大的接口变量,由SK 海力士与闪迪在FMS 2026联合首披露规范:有两种堆叠配置(8-Hi与16-Hi die),容量上限是512GB。第一代产品目标约1.6 TB/s、微秒级延迟、HBM容量的8–16倍,介于HBM与NVMe SSD(7–14GB/s)之间。
传统的NAND一般都是挂在SSD控制器之后,通过PCIe的方式连到CPU。而HBM之所以快,是因为“距离短、接口宽”,直接紧贴GPU。而HBF就是将这套封装级接口直接给NAND用上,使得HBF能获得“HBM级的读取带宽+8-16倍于HBM的容量”。
值得注意的是,由于物理特性的区别,HBF的随机读取的延迟约为10us(HBM为10-100ns),大约差了100-1000倍。HBF并不会完全替代HBM,只是在HBM与SSD之间新添加了一层,更适用于密集推理场景——权重和大型上下文可以预取,单次读慢没关系,只要并行度够高。
闪迪的HBF进展:首颗HBF die已流片,首批推理产品样品预计2027年(CY27)交付
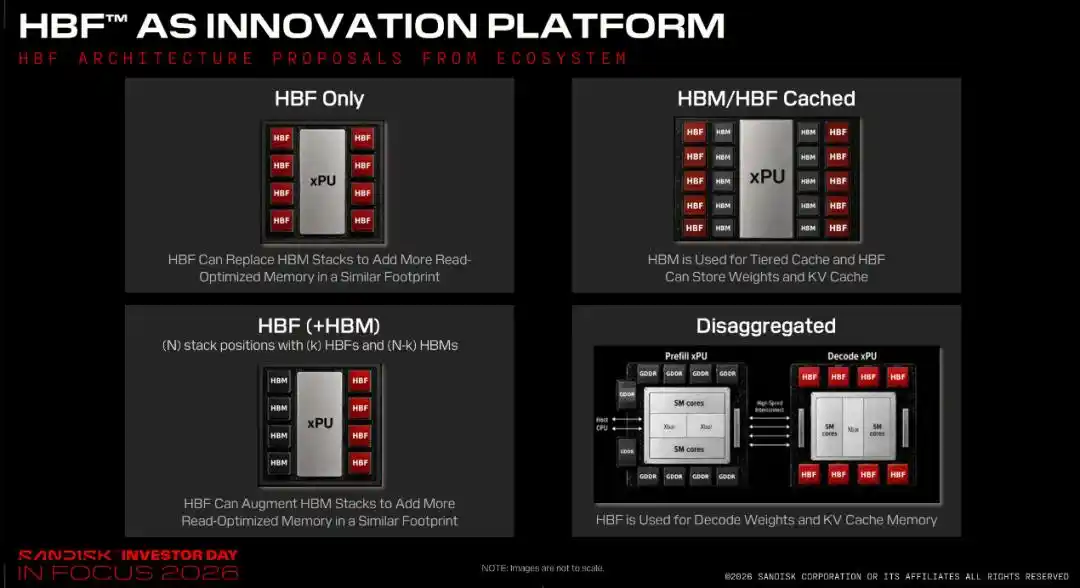
闪迪给出的HBF四种部署形态
① 替代型:纯HBF。在相近的封装面积内,把HBM堆叠位全部换成HBF,权重和KV cache都放在HBF里。容量优势最大化(同等带宽下8–16倍容量),但没有HBM做缓冲,也没有写入缓冲,是四种里对NAND写入寿命最敏感的一种(每生成一个token产生的KV都直接砸在NAND上)。
注:编程和擦除要靠高压把电子打穿隧穿氧化层,每一次都会在氧化层里留下陷阱电荷,累积到一定程度cell就再也关不住电荷了
② 缓存型:HBM/HBF Cached。HBM退到前端做低延迟缓存层,权重和KV cache都存在HBF。相对纯HBF降低了HBF的访问频次,但只要KV数据最终落在HBF上,写入约束依然存在。
③ 增配型:HBF+HBM混搭。HBF占据xPU周边的一部分堆叠位,剩下的仍然是HBM,两者分工。这是门槛最低的一种——不要求加速器厂商放弃HBM就能把HBF塞进插槽,所以也最可能是第一代产品的落地形态。权重放HBF、KV cache留在HBM。
④ 解耦型:Disaggregated。HBF从计算单元旁边挪开、独立成池,存放decode阶段的权重和KV cache,旁边配一个较小的HBM层做缓存。由于HBF大概率不会整体替代HBM,有机会催生AI推理的解耦式架构——HBF联盟里已经有谷歌、Meta、SK海力士和Tenstorrent都在推这个方向。
综合以上4个主要维度来看,闪迪的整体技术仍相对领先,主要体现在位密度、CBA技术和接口等方面(含HBF)。闪迪公司原本在层数上稍显落后,但随着BiCS10的量产也紧跟上了第一梯队的步伐。
海力士和三星也已经开始引入CBA键合技术,至于美光的重心仍在DRAM领域,对NAND的关注度相对较低,因而在NAND的技术进展方面是相对偏慢的。
海豚君在本文中主要围绕闪迪与西部的关系、与铠侠的合作、以及NAND技术的情况展开,而在下文中将主要围绕于公司的业务进展及估值定价展开,欢迎关注并阅读。
本文来自微信公众号“海豚投研”(ID:haituntouyan),作者:海豚君
为你推荐
商务合作:TG:@Lottie96
Copyright 火星财经 All Rights Reserved.