


RSI新突破,UC Berkeley、Sakana AI团队提出「多Agent自监督」MASS
加州大学伯克利分校与Sakana AI团队提出多Agent自监督(MASS)方法,通过让同一模型交替担任任务求解、工作流优化和评估角色,在冻结权重下搜索最优多Agent协作工作流,并将高质量执行轨迹蒸馏回共享模型,显著提升科研任务胜率与基准得分,为递归自我改进(RSI)提供可靠自监督机制。
 摘要由 Mars AI 生成
改进的球堆积界、新的胶子散射公式,以及经实验验证的纳米抗体设计……前沿 AI 系统已经开始在科学研究中取得原创性成果。
如何让这一进程持续下去,并进一步提高研究效率?递归自我改进(Recursive Self-Improvement,RSI)被视为一个有潜力的方向。
RSI 主要由评估与改进两个核心组件驱动。然而,在前沿科研中,这两个环节都面临现实困难:在评估方面,如果研究成果超出了现有人类专家的判断能力,或者实验反馈需要等待很长时间,就很难获得可靠的评估结果;在改进方面,模型需要通过高质量的执行轨迹来学习,而这些轨迹的质量又取决于工作流是否合理。要针对不同任务和领域,逐一调整任务分解、工具使用和结果验证等环节,人工成本很高,也难以推广。
问题还在于,模型往往需要依靠自己来判断和改进自己的表现。任务生成、结果评估和工作流调整都建立在模型已有的知识与判断之上。如果这些判断本身存在偏差,自我反馈就可能让错误不断延续。
为此,加州大学伯克利分校、Sakana AI 团队提出了“多 Agent 自监督”(Multi-Agent Self-Supervision,MASS),利用多 Agent 协调来为 RSI 生成自监督。
论文链接:https://arxiv.org/pdf/2610.12176
具体而言,他们让同一个模型交替担任任务求解 Agent、工作流优化器与评估器,先在冻结权重的前提下优化“多个自身副本如何协作”,再把协作产生的轨迹蒸馏回共享权重。
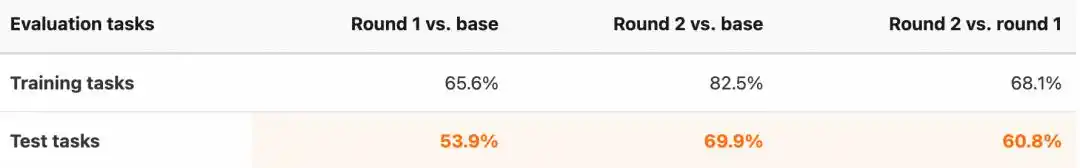
经过两轮 MASS 循环后,Qwen3.6-27B 在三个测试任务上对外部强模型裁判的胜率从 53.9% 升至 69.9%,在四个公开科研基准上单位输出 Token 的得分达到基座模型的1.2–1.6 倍。
另外,他们还发现,经过优化的工作流会根据任务特点安排信息传递和 Agent 路由。在第一轮实验中,多 Agent 学生模型相对于基座模型的胜率达到 68.3%。作为对照,单 Agent 学生模型使用了多出约 1.4 倍的已处理监督 Token 进行训练,胜率为 64.0%。这表明,联合学习编排与有界的子 Agent 执行,能为 RSI 提供更有效的监督。
这些结果表明,优化 Agent 之间的协作方式,并让各个子 Agent 在明确的任务范围内执行工作,有助于提高训练数据的质量,为模型的持续改进提供更有效的监督信号。
一、研究方法
MASS 先通过优化工作流激发多 Agent 团队的集体智能,再将团队经验蒸馏到共享模型中。内循环在模型权重保持固定的前提下优化团队工作流,模型自己评估并判断哪个工作流最优;外循环则通过学习优化后工作流的执行来更新权重。如下动画演示:
视频|MASS 动画演示。工作流搜索改变了各 Agent 之间的协作方式;基于所选执行轨迹的训练,会将这些经验沉淀到共享权重中;更新后的模型随即重新承担全部三个角色。
1.准备阶段:工作流即Prompt
工作流(workflow)是一份关于多 Agent 团队如何协作的书面计划。编排器负责向 subagent 分派工作并整合结果。这份计划会被附加到任务 Prompt 中,使团队的组织方式可以被模型检视和修改,包含四个部分:
- 角色(Role):分派给每个 subagent 的职责,如准备数据。
- 指令(Instruction):该 subagent 应执行的工作。
- 契约(Contract):它必须返回的信息和工件,包括任何必需的检查。
- 调用顺序(Hop):subagent 的调用顺序,包括对先前步骤的回返。
如果让历史决策用到了未来的信息,一个回测可以看起来很有说服力。这份契约要求数据专家检查这类错误,并报告时间切分是否有效。它还告诉后续的 Agent:在继续之前应该收到哪些证据。于是,研究计划的一部分就表达成了“Agent 必须确立什么、必须相互传递什么”。
2.内循环:搜索更好的工作流
对每个训练任务,MASS 保留一个冠军(champion):按当前模型的判断,迄今为止找到的最佳工作流。每次迭代有三个步骤:
- 执行(Execute):团队按候选工作流执行并产出一个工作区。
- 评估(Evaluate):评估器把这个工作区与冠军的工作区做比较,并解释哪个更好。获胜的候选成为新冠军。
- 修订(Revise):优化器利用反馈历史提出下一个工作流。
评估器评判的是已完成的工作;优化器则利用这一判断去修订产出这份工作的过程。优化器的系统 Prompt 强调契约与调用顺序(hop),把工作流搜索导向“Agent 之间交换什么信息、何时收到信息”。
3.外循环:向选出的团队学习
即使有了优化后的工作流,长程研究工作的质量在每次运行之间仍可能波动。因此,MASS 用多个随机种子执行自评最优的工作流(即冠军工作流,指迄今为止找到的最优工作流),用当前模型对产出的工作区排序,保留排名最高的轨迹。每条轨迹(trajectory) 记录编排器及其子代理的消息、工具调用和工具结果。
- 对每个任务,将冠军工作流运行 18 次。
- 用当前模型比较并对产出的工作区排序。
- 每个任务最多保留 16 条轨迹:15 条用于训练,1 条用于验证。
- 构造训练样本时,把工作流文本从编排器的初始 Prompt 中移除。
- 用 LoRA 在编排器和子代理的对话上微调共享模型。模型的输出是训练目标;任务 Prompt 和工具结果提供上下文。
把工作流从编排器的训练 Prompt 中移除,可以促使模型学会从任务本身出发组织工作。
二、实验结果
研究团队以 Qwen3.6-27B 为基座,在 qwen-code 编程 Agent 环境中运行了两轮 MASS。实验使用 12 个合成研究任务,覆盖金融、机器人和制药领域,每个任务要求交付代码、量化结果和研究报告,其中 9 个用于训练,3 个留出测试。GPT-5.5 和 Claude Opus 4.8 担任外部评委,其判断不参与 MASS 的任何环节。
在留出的测试任务上,模型对基座模型的胜率从第一轮的 53.9% 升至第二轮的 69.9%,第二轮对第一轮的胜率为 60.8%。
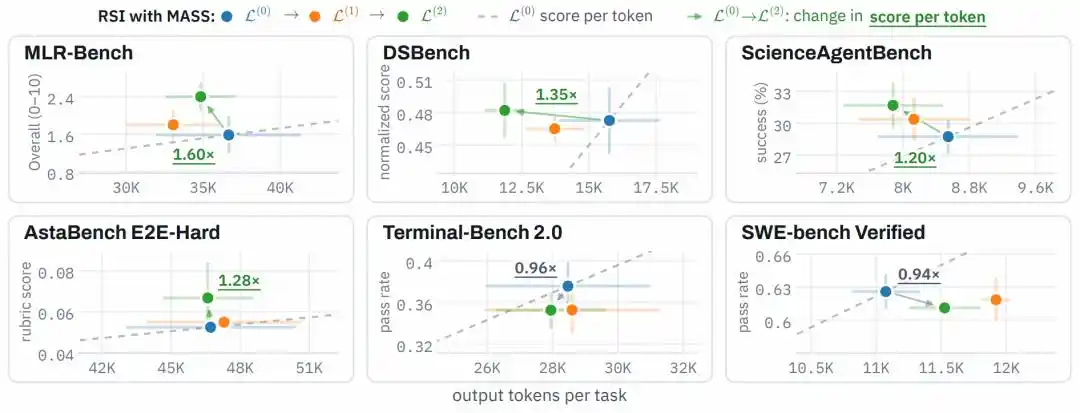
在 6 个公开基准上,经两轮训练后,模型的每输出 Token 得分相较基座模型分别达到:MLR-Bench 的 1.60 倍、DSBench 的 1.35 倍、AstaBench E2E-Hard 的 1.28 倍和 ScienceAgentBench 的 1.20 倍。相比之下,Terminal-Bench 2.0 和 SWE-bench Verified 分别为 0.96 倍和 0.94 倍,说明提升在不同任务间并不均衡。研究团队推测,在训练数据中加入软件工程任务,或可改善这两个基准上的表现。
值得注意的是,训练数据只包含任务求解轨迹,但工作流优化和自我评估两个角色的能力也同步提升:
- 自我评估:评估器与外部评委的一致率从 0.73 升至 0.91,再升至 0.93。
- 工作流优化:第一轮模型生成的工作流,即使交给基座模型执行,也在 64% 的对比中优于基座模型自己生成的工作流。
- 搜索速度:训练后的模型能更早找到有效工作流。
多 Agent 轨迹的训练效率同样更高。M+(第一轮 MASS 模型)处理 28.8M 个监督 Token,对基座模型的胜率为 68.3%;单 Agent 轨迹训练的 S++ 处理 42M 个监督 Token,胜率为 64.0%。前者少用 31% 的监督 Token,胜率反而更高。该 Token 数不含数据生成、工作流搜索和评估的开销。
在优化器与评估者的对比实验中,执行者固定为基座模型,评估者和优化器同时换成 GPT-5.5 后,5 次迭代内即为全部 12 个任务找到优于无工作流基座模型的工作流;只更换评估者,收益明显更小。全部由基座模型担任的同质闭环速度较慢,但到第 13 次迭代时也覆盖了 11 个任务。研究团队认为,预算有限时应优先升级优化器。
以上结果表明,MASS 能为 RSI 提供有效的自监督。研究团队表示,如何加快每个周期中性能提升的速度,仍是未来工作的重要方向。
本文来自微信公众号“学术头条”(ID:SciTouTiao),作者:学术头条
为你推荐
商务合作:TG:@Lottie96
Copyright 火星财经 All Rights Reserved.